
0x09 python基础&爬虫&信息收集
一、python基础
1、python前言
(一)解释器
计算机不能直接理解任何除机器语言以外的语言,必须要把程序语言翻译成机器语言,计算机才能执行程序。
编译器:将其他语言翻译成机器语言的工具
编译器翻译的方式:编译,解释。
两种方式的区别在于翻译时间点的不同。当编译器以解释方式运行的时候,也称之为解释器
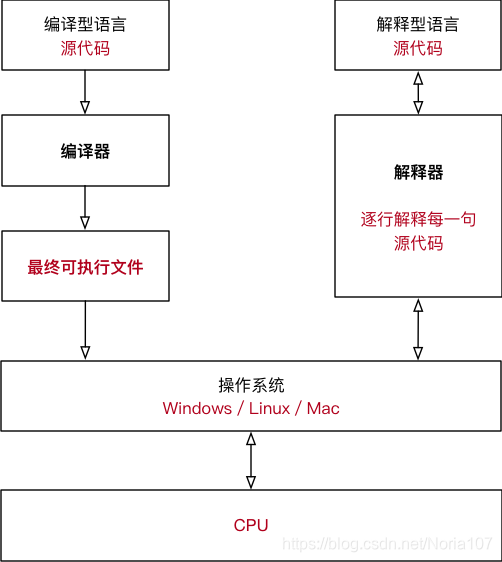
**编译型语言:**程序执行之前需要有一个专门的编译过程,把程序编译成为机器语言的文件,运行时不需要重新翻译,直接使用编译的结果就行了。程序执行效率高,依赖编译器,跨平台性差些。
**解释型语言:**解释型语言编写的程序不进行预先编译,以文本方式存储程序代码,会将代码一句一句直接运行。在发布程序时,看起来省了道编译工序,但是在运行程序的时候,必须先解释再运行
编译型语言和解释型语言对比
- 速度:编译比解释型快
- 跨平台性:解释比编译跨好
(二)Python 特点
1、完全面向对象的语言
函数、模块、数字、字符串都是对象,Python中一切皆对象
完全支持继承、重载、多重继承
支持重载运算符,也支持泛型设计
2、拥有一个强大的标准库
Python标准库提供了 系统管理、网络通信、文本处理、数据库接口、图形系统、XML 处理 等额外的功能
3、有大量的第三方模块
使用方式与标准库类似。它们的功能覆盖 科学计算、人工智能、机器学习、Web 开发、数据库接口、图形系统 多个领域
(三)面向对象的思维方式
面向对象 是一种 思维方式,也是一门 程序设计技术
要解决一个问题前,首先考虑 由谁 来做,怎么做事情是 谁 的职责,最后把事情做好就行!
对象 就是 谁
要解决复杂的问题,就可以找多个不同的对象,各司其职,共同实现,最终完成需求 先找一个可以完成功能的对象,并且使用对象所提供的能力来解决问题
(四)Python 的优缺点
(1)优点
1、简单、易学
2、免费、开源
3、面向对象
4、丰富的库
5、可扩展性 1>如果需要一段关键代码运行得更快或者希望某些算法不公开,可以把这部分程序用 C 或 C++ 编写,然后在 Python 程序中使用它们
(2)缺点
1、运行速度差一点
2、国内市场较小
3、中文资料匮乏
(五)执行 python 程序的三种方式
- 解释器 ——
python/python3 - 交互式 ——
ipython - 集成开发环境 ——
PyCharm
注:
-
可以使用任意文本编辑软件做
Python的开发 -
文件扩展名 通常都是
.py
(1)单词列表
* error 错误* name 名字* defined 已经定义* syntax 语法* invalid 无效* Indentation 索引* unexpected 意外的,不期望的* character 字符* line 行* encoding 编码* declared 声明* details 细节,详细信息* ASCII 一种字符编码(2)python的运行方式
Python 的解释器
# 使用 python 2.x 解释器$ python xxx.py
# 使用 python 3.x 解释器$ python3 xxx.py(3)交互式运行 Python 程序
1、直接在终端中运行解释器,而不输入要执行的文件名
2、在 Python 的 Shell 中直接输入 Python 的代码,会立即看到程序执行结果
1)交互式运行 Python 的优缺点
1.优点
适合于学习/验证 Python 语法或者局部代码
2.缺点
1>代码不能保存
2>不适合运行太大的程序
2)退出 官方的解释器
1> 直接输入 exit()
>>> exit()2> 使用热键退出
按热键 ctrl + d 可以退出解释器
2、变量
程序就是用来处理数据的,而变量就是用来存储数据的
(一)变量类型
Python 中数据类型可以分为 数字型 和 非数字型
1.数字型
整型 (int)
浮点型(float)
布尔型(bool) 真 True 非 0 数 —— 非零即真 假 False 0
复数型 (complex) 主要用于科学计算,例如:平面场问题、波动问题、电感电容等问题
2.非数字型
字符串
列表
元组
字典
在 Python 中,所有 非数字型变量 都支持以下特点:
都是一个 序列 sequence,也可以理解为 容器
取值 []
遍历 for in
计算长度、最大/最小值、比较、删除
链接 + 和 重复 *****
切片
(二)变量定义
每个变量 在使用前都必须赋值,变量 赋值以后 该变量 才会被创建
变量名 = 值变量:先定义,后使用
(三)变量的类型
在内存中创建一个变量,会包括:
1.变量的名称
2.变量保存的数据
3.变量存储数据的类型
4.变量的地址(标示)
(1)变量的类型
在 Python 中定义变量是 不需要指定类型
数据类型可分为 数字型 和 非数字型
数字型
整型 (int)
浮点型(float)
布尔型(bool) 真 True 非 0 数 —— 非零即真 假 False 0
复数型 (complex) 主要用于科学计算,例如:平面场问题、波动问题、电感电容等问题
非数字型
字符串
列表
元组
字典
(2)不同类型变量之间的计算
1.数字型变量 之间可以直接计算
在 Python 中,两个数字型变量是可以直接进行算数运算的
如果变量是 bool 型,在计算时
True 对应的数字是 1 False 对应的数字是 0
2.字符串变量 之间使用 + 拼接字符串
字符串变量 可以和 整数 使用 * 重复拼接相同的字符串
数字型变量 和 字符串 之间 不能进行其他计算
(3)变量的输入
所谓 输入,就是 用代码 获取 用户通过 键盘 输入的信息
在 Python 中,使用 input 函数
input 函数实现键盘输入
在 Python 中可以使用 input 函数从键盘等待用户的输入
用户输入的 任何内容 Python 都认为是一个 字符串
语法如下:
字符串变量 = input("提示信息:")(4)变量的格式化输出
格式化操作符
- % 被称为格式化操作符,专门用于处理字符串中的格式
2.包含 % 的字符串,被称为 格式化字符串
- % 和不同的 字符 连用,不同类型的数据 需要使用 不同的格式化字符
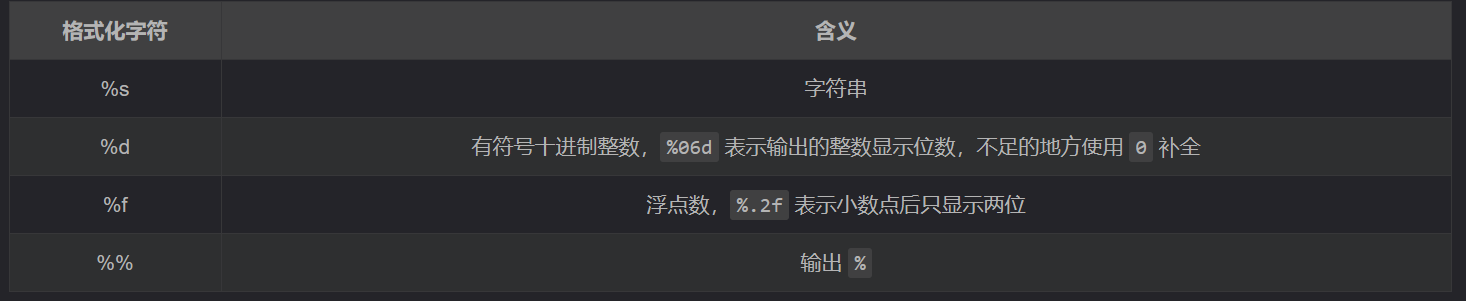
语法格式如下:
print("格式化字符串" % 变量1)
print("格式化字符串" % (变量1, 变量2...))(四)标识符和关键字
(1)标识符
标示符就是程序员定义的 变量名、函数名
名字 要 见名知义
1.标示符可以由 字母、下划线 和 数字 组成
2.不能以数字开头
3.不能与关键字重名
(2)关键字
关键字 就是在 Python 内部已经使用的标识符
关键字 具有特殊的功能和含义
不允许定义和关键字相同的名字的标示符
(五)变量的命名规则
注意 Python 中的 标识符 是 区分大小写的
1.在定义变量时,为了保证代码格式,= 的左右应该各保留一个空格
2.在 Python 中,如果 变量名 需要由 二个 或 多个单词 组成时,可以按照以下方式命名
1)每个单词都使用小写字母
2)小驼峰式命名法 第一个单词以小写字母开始,后续单词的首字母大写
3)大驼峰式命名法 每一个单词的首字母都采用大写字母
(六)变量进阶
(1)变量的引用
- 变量和数据 都是保存在 内存 中的
- 在
Python中 函数 的 参数传递 以及 返回值 都是靠 引用 传递的
1)引用的概念
在 Python 中 :
变量 和 数据 是分开存储的
数据 保存在内存中的一个位置
变量 中保存着数据在内存中的地址
变量 中 记录数据的地址,即 引用
使用 id() 函数查看变量中保存数据所在的 内存地址
**注意:**若变量已被定义,当给一个变量赋值的时候,本质上是 修改了数据的引用
1.变量 不再 对之前的数据引用
2.变量 改为 对新赋值的数据引用
2)函数的参数和返回值的传递
在 Python 中,函数的 实参/返回值 都是是靠 引用 来传递来的
(2)可变和不可变类型
不可变类型,内存中的数据不允许被修改:
1.数字类型 int, bool, float, complex, long(2.x)
2.字符串 str
3.元组 tuple
可变类型,内存中的数据可以被修改:
1.列表 list
2.字典 dict
注意:字典的 key 只能使用不可变类型的数据
注意
1.可变类型的数据变化,是通过 方法 来实现的
2.若给一个可变类型的变量,赋值了一个新的数据,引用会修改
变量 不再 对之前的数据引用
变量 改为 对新赋值的数据引用
(3)哈希 (hash)
1.Python 中内置有一个名字叫做 hash(o) 的函数
接收一个 不可变类型 的数据作为 参数
返回 结果是一个 整数
2.哈希 是一种 算法,其作用就是提取数据的 特征码(指纹)
相同的内容 得到 相同的结果
不同的内容 得到 不同的结果
3.在 Python 中,设置字典的 键值对 时,会首先对 key 进行 hash 已决定如何在内存中保存字典的数据,以方便 后续 对字典的操作:增、删、改、查
key 必须是不可变类型数据
value 可以是任意类型的数据
(4)局部变量和全局变量
1.局部变量 是在 函数内部 定义的变量,只能在函数内部使用
2.全局变量 是在 函数外部定义 的变量(没有定义在某一个函数内),所有函数 内部 都可以使用这个变量
1)局部变量
1.局部变量 是在 函数内部 定义的变量,只能在函数内部使用
2.函数执行结束后,局部变量,会被系统回收
3.不同的函数,可以定义相同的名字的局部变量,但是 彼此之间 不会产生影响
2)局部变量的作用
在函数内部使用,临时 保存 函数内部需要使用的数据
3)局部变量的生命周期
1.所谓 生命周期 就是变量从 被创建 到 被系统回收 的过程
2.局部变量 在 函数执行时 才会被创建
3.函数执行结束后 局部变量 被系统回收
4.局部变量在生命周期 内,可以用来存储 函数内部临时使用到的数据
4)全局变量
全局变量 是在 函数外部定义 的变量,所有函数内部都可以使用这个变量
**注意:**函数执行时,需要处理变量时 会:
1.首先 查找 函数内部 是否存在 指定名称 的局部变量,如果有,直接使用
2.若没有,查找 函数外部 是否存在 指定名称 的全局变量,如果有,直接使用
3.若还没有,程序报错!
5)函数不能直接修改全局变量的引用
1.全局变量 是在 函数外部定义 的变量(没有定义在某一个函数内),所有函数 内部 都可以使用这个变量
2.在函数内部,可以 通过全局变量的引用获取对应的数据
3.但是,不允许直接修改全局变量的引用 —— 使用赋值语句修改全局变量的值
**注:**只是在函数内部定义了一个局部变量而已,只是变量名相同 —— 在函数内部不能直接修改全局变量的值
6)在函数内部修改全局变量的值
若在函数中需要修改全局变量,需要使用 global 进行声明
7)全局变量定义的位置
将全局变量定义在其他函数的上方
3、运算符
(一)算数运算符
- 是完成基本的算术运算使用的符号,用来处理四则运算
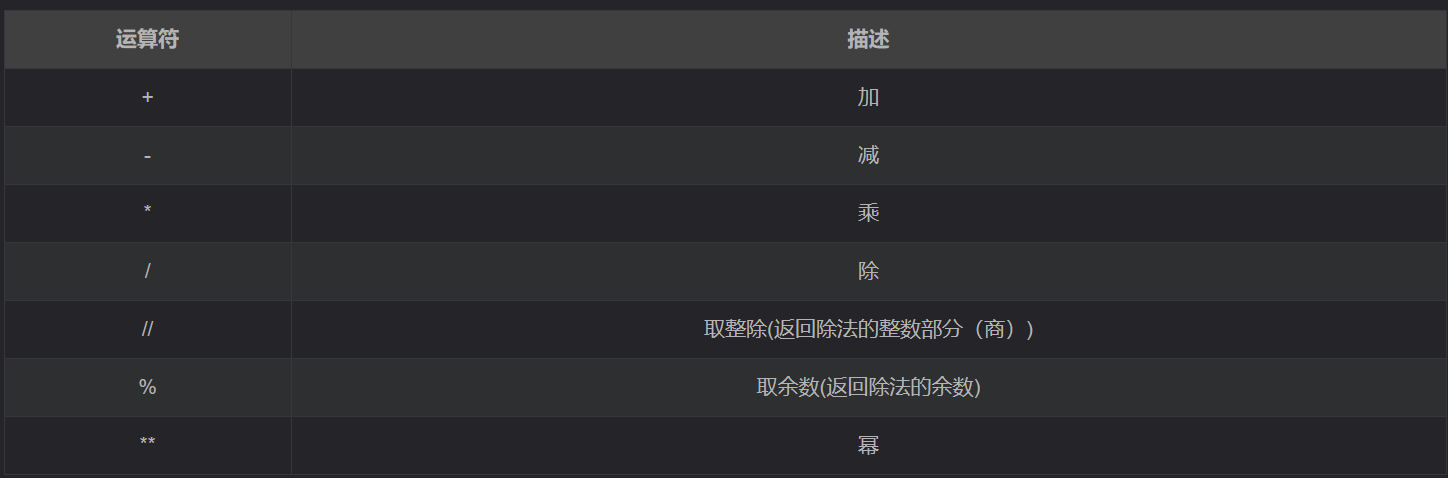
在 Python 中 * 还可以用于字符串,结果是字符串重复指定次数的结果
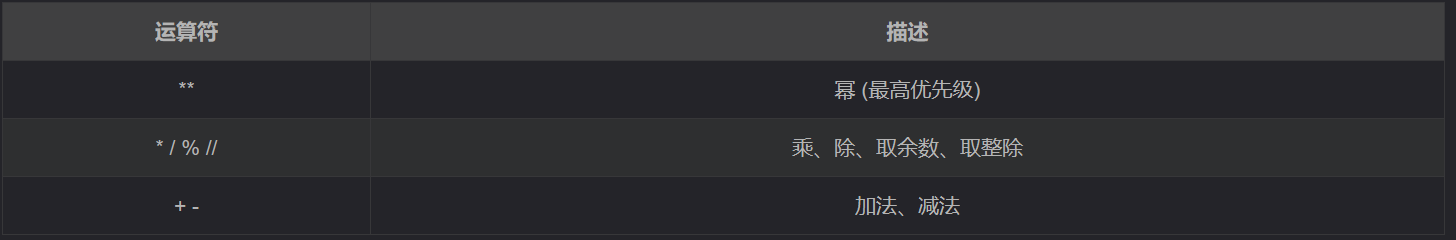
优先级
- 先乘除后加减
- 同级运算符是 从左至右 计算
- 可以使用
()调整计算的优先级 - 算数优先级由高到最低顺序排列
(二)比较(关系)运算符
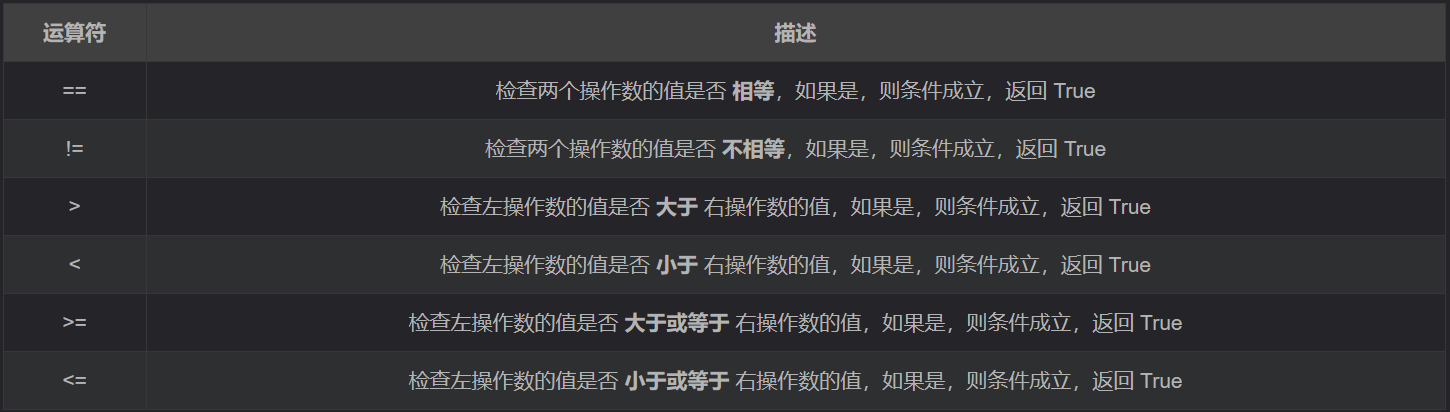
Python 2.x 中判断 不等于 还可以使用 < > 运算符
! = 在 Python 2.x 中同样可以用来判断 不等于
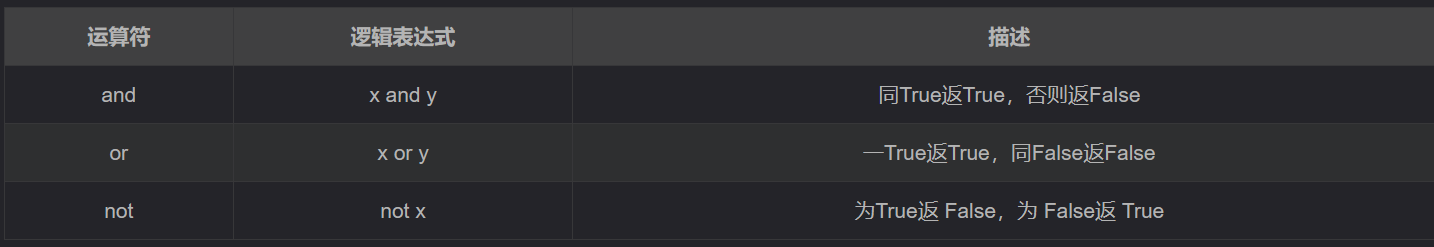
(三)逻辑运算符
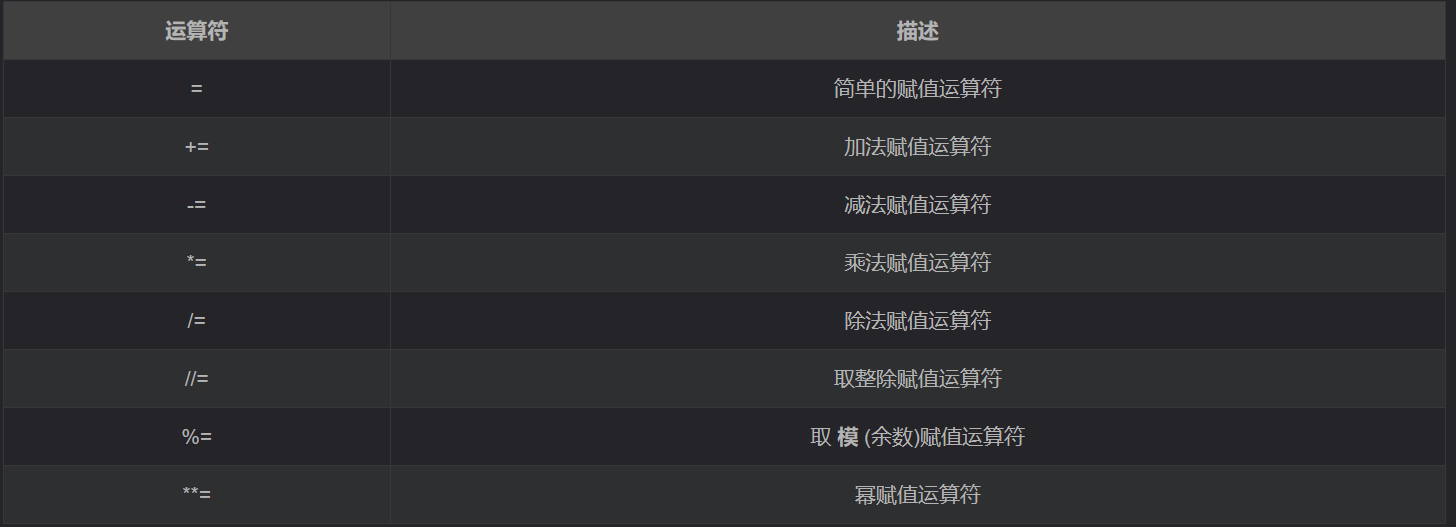
(四)赋值运算符
- 注:赋值运算符中间不能使用空格
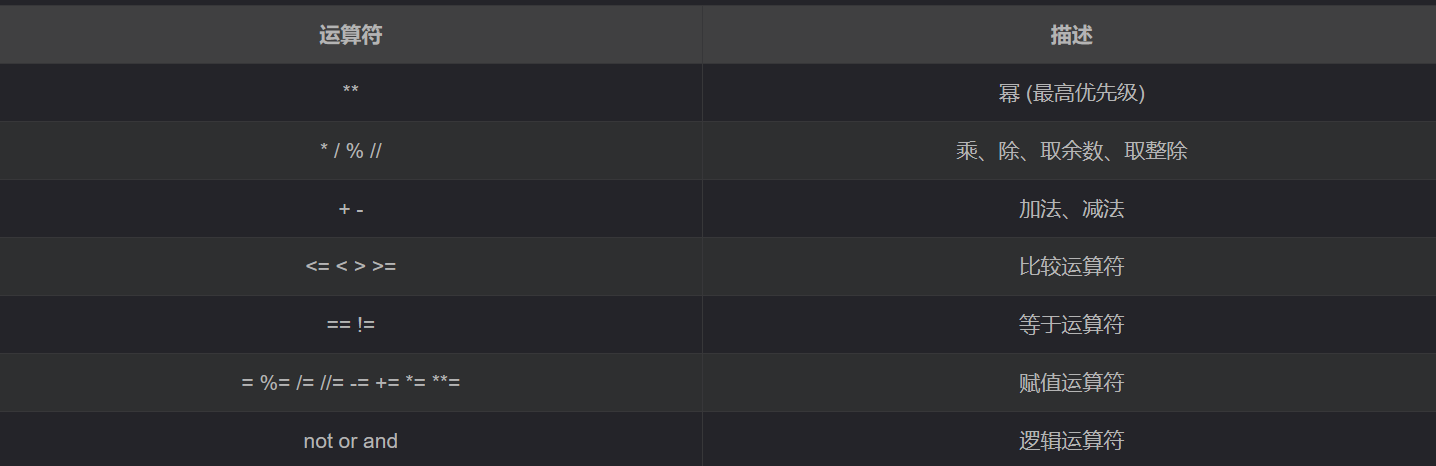
(五)运算符的优先级
- 表格算数优先级由高到最低顺序排列
4、字符串
(一)字符串的定义
1.字符串 就是 一串字符,是编程语言中表示文本的数据类型
2.在 Python 中可以使用 一对双引号 ” 或者 一对单引号 ’ 定义一个字符串
虽然可以使用 \” 或者 \’ 做字符串的转义,但在实际开发中:
3.如果字符串内部需要使用 “,可以使用 ’ 定义字符串 4.如果字符串内部需要使用 ‘,可以使用 ” 定义字符串
5.可以使用 索引 获取一个字符串中 指定位置的字符,索引计数从 0 开始
6.也可以使用 for 循环遍历 字符串中每一个字符
大多数编程语言都是用 " 来定义字符串
string = "Hello Python"
for c in string: print(c)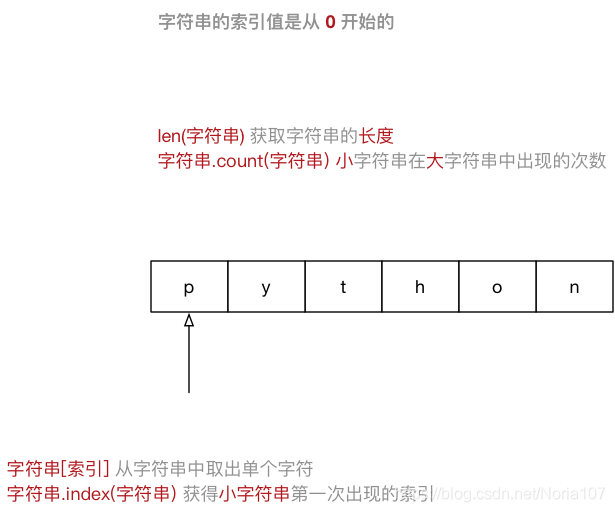
(二)字符串的常用操作
(1)判断类型
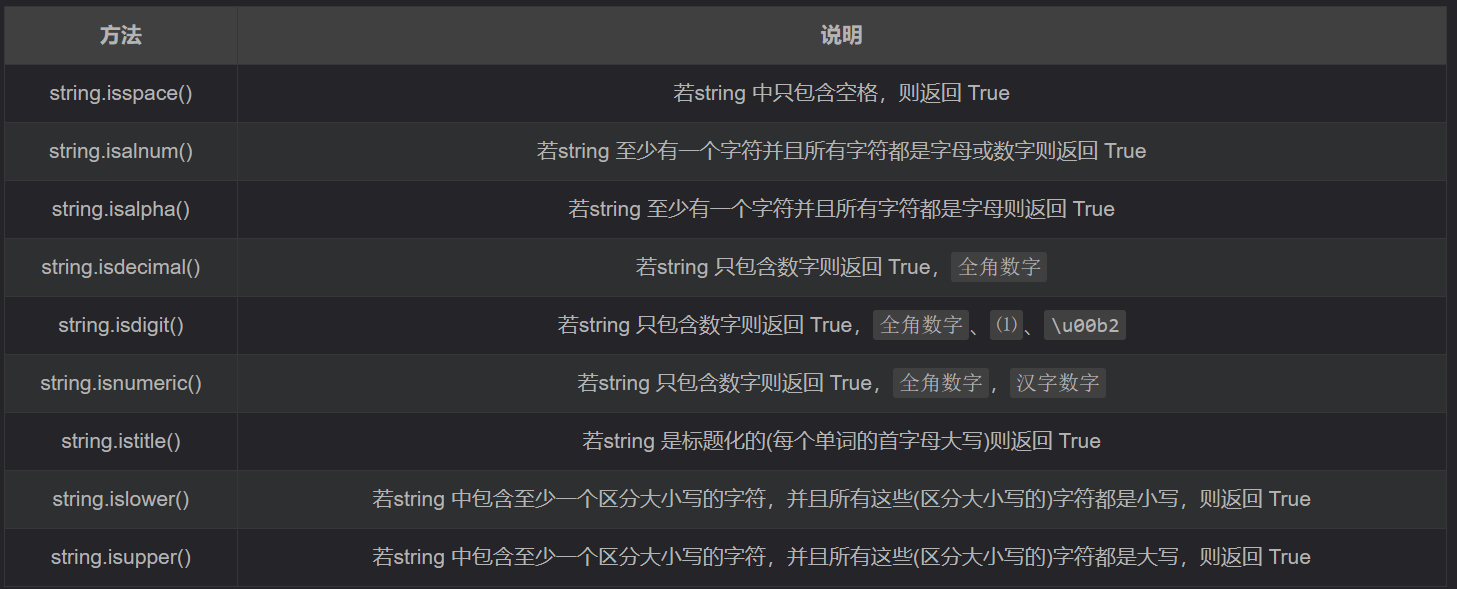
(2)查找和替换
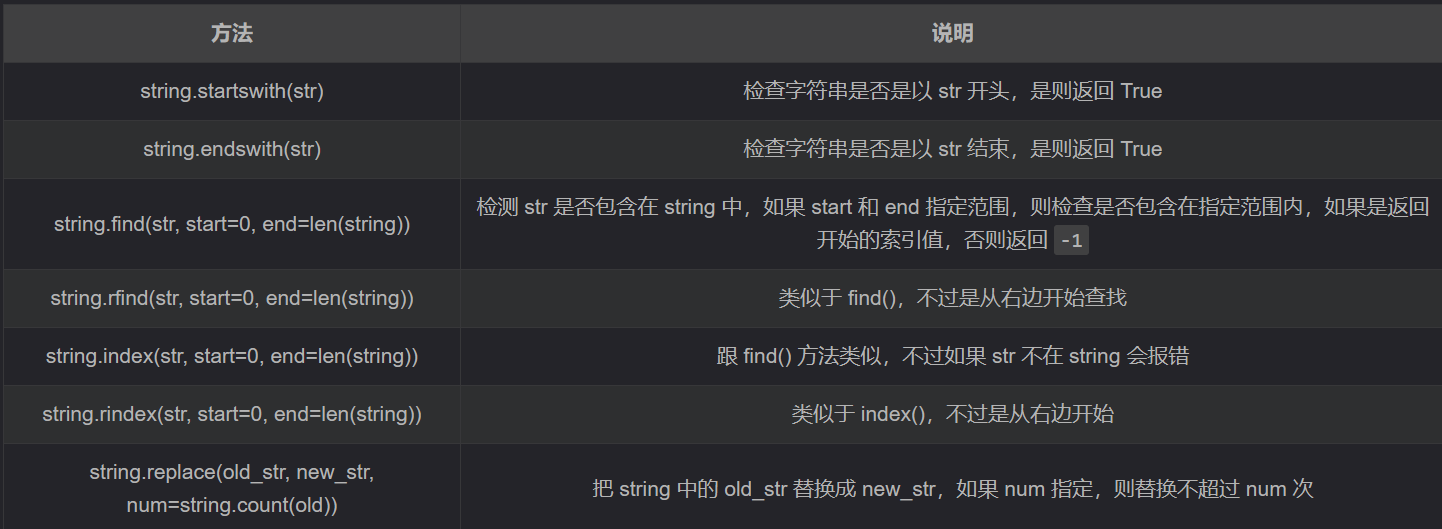
(3)大小写转换
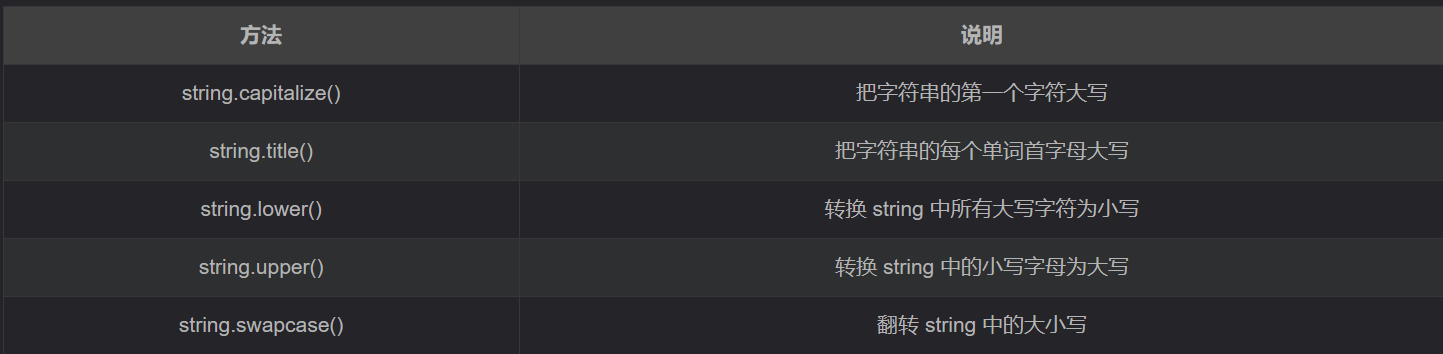
(4)文本对齐
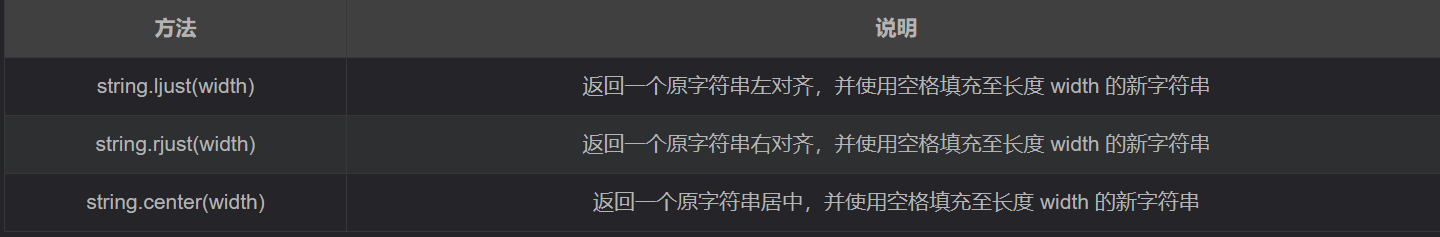
(5)去除空白字符
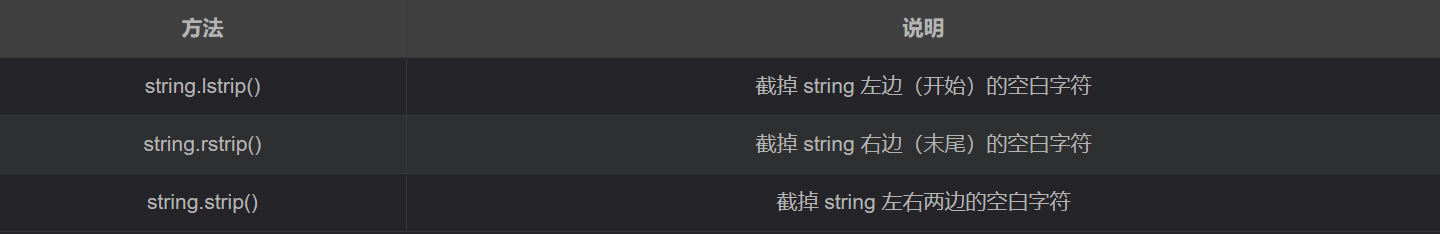
(6)拆分和连接
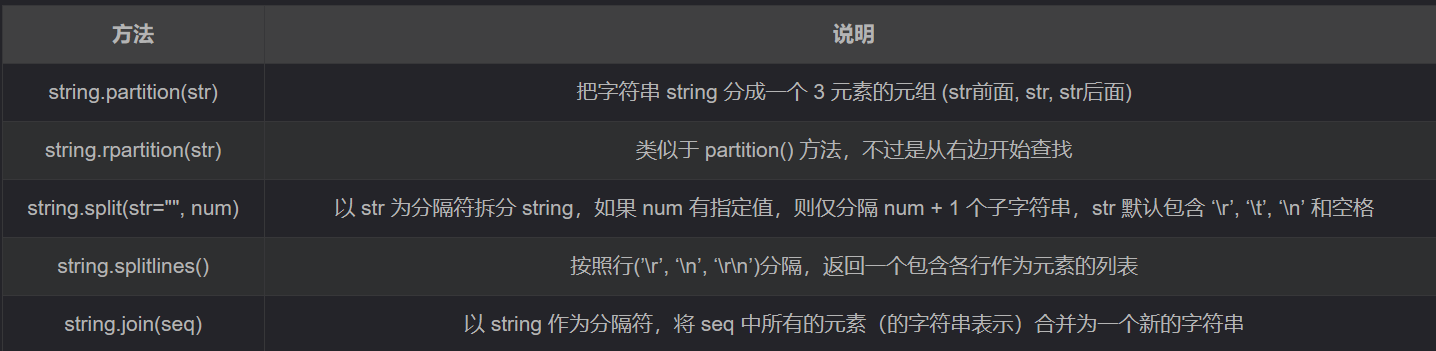
(7)字符串的切片
切片 方法适用于 字符串、列表、元组
- 切片 使用 索引值 来限定范围,从一个大的 字符串 中 切出 小的 字符串
- 列表 和 元组 都是 有序 的集合,都能够 通过索引值 获取到对应的数据
- 字典 : 无序 集合,使用 键值对 保存数据
字符串[开始索引:结束索引:步长]注意:
1.指定的区间属于 左闭右开 型 [开始索引, 结束索引) => 开始索引 >= 范围 < 结束索引 从 起始 位开始,到 结束 位的前一位 结束**(不包含结束位本身)** 2.从头开始,开始索引 数字可以省略,冒号不能省略 3.到末尾结束,结束索引 数字可以省略,冒号不能省略 4.步长默认为 1,如果连续切片,数字和冒号都可以省略
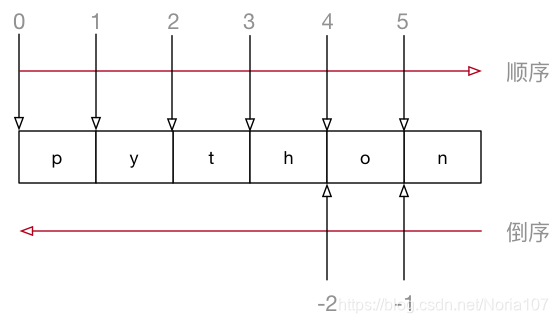
(8)索引的顺序和倒序
1.在 Python 中支持 顺序索引,还支持 倒序索引
2.所谓倒序索引就是 从右向左 计算索引 最右边的索引值是 -1,依次递减
5、列表
(一)列表的定义
-
List(列表) 是Python中使用 最频繁 的数据类型,在其他语言中通常叫做 数组 -
专门用于存储 一串 信息
-
列表用
[]定义,数据 之间使用,分隔 -
列表的 **索引 **从 0 开始
- 索引 就是数据在 列表 中的位置编号,索引 又可以被称为 下标
注意:从列表中取值时,如果 超出索引范围,程序会报错
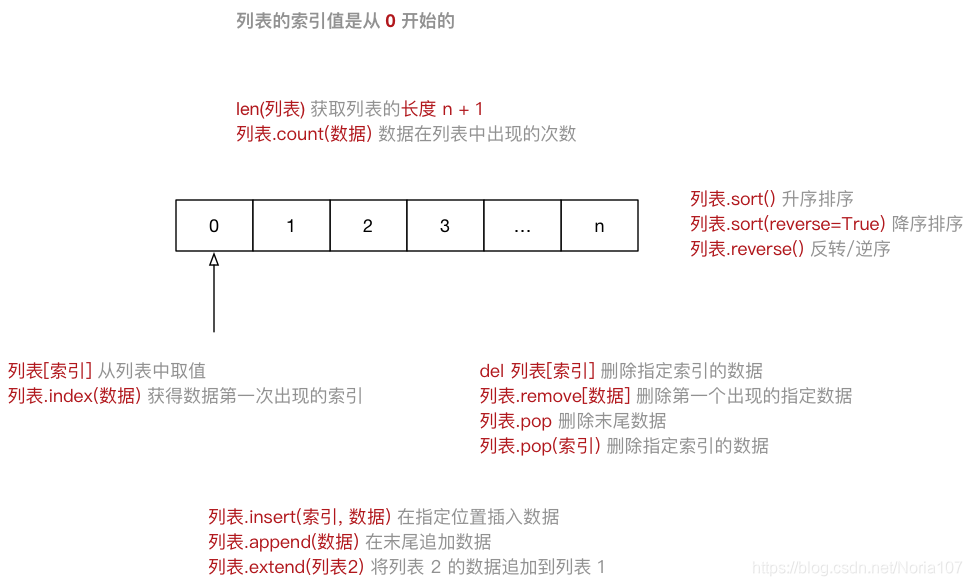
(二)列表常用操作
- 定义一个 列表,例如:
name_list = []
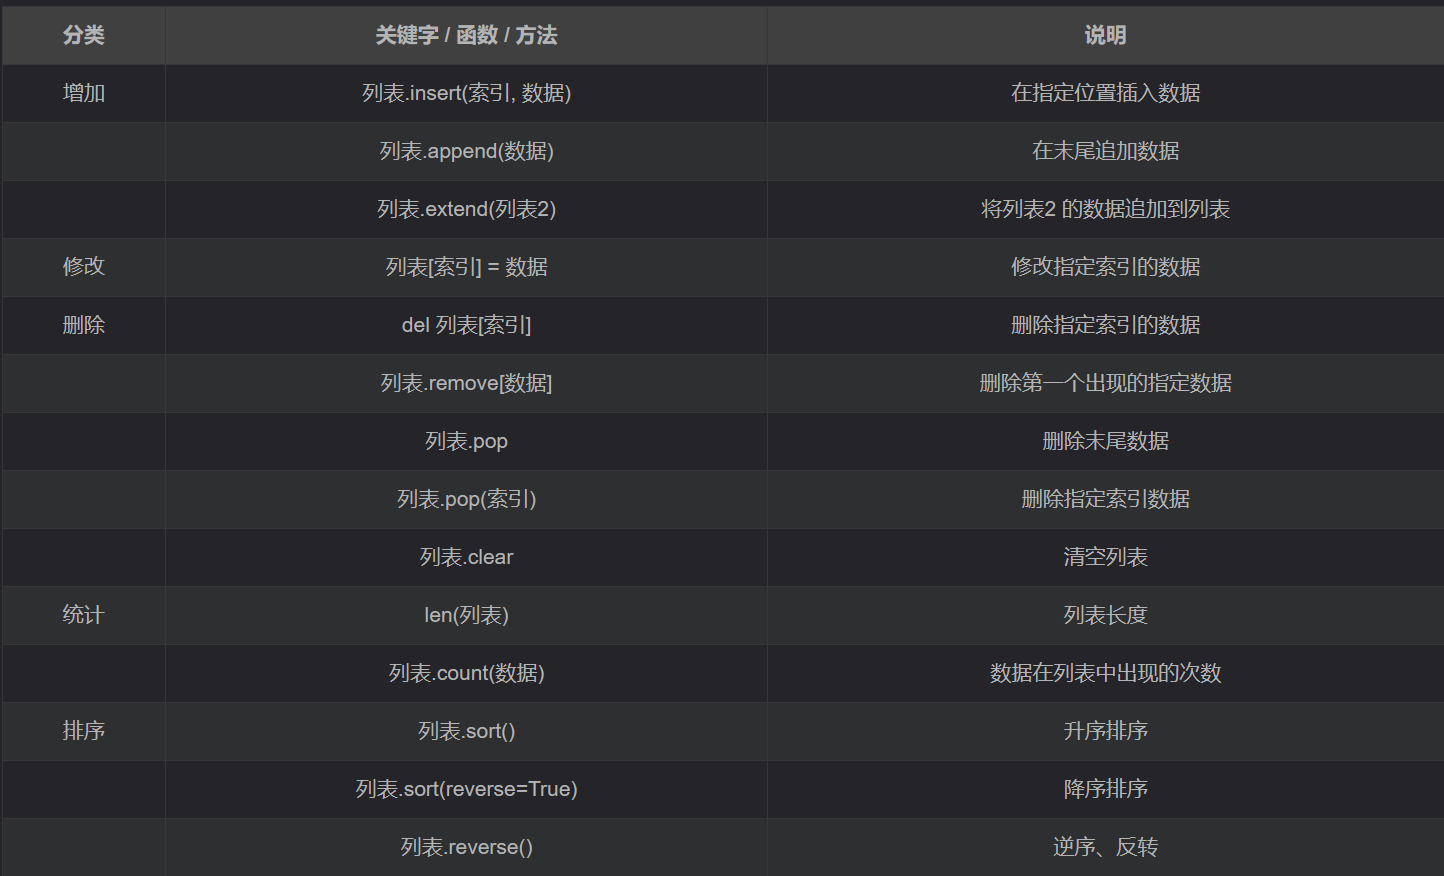
(三)关键字(科普)
- 使用
del关键字(delete) 同样可以删除列表中元素 del关键字本质上是用来 将一个变量从内存中删除的- 如果使用
del关键字将变量从内存中删除,后续的代码就不能再使用这个变量了
del name_list[1](四)循环遍历
- 遍历 就是 从头到尾 依次 从 列表 中获取数据
- 在 循环体内部 针对 每一个元素,执行相同的操作
- 在
Python中为了提高列表的遍历效率,专门提供的 迭代 iteration 遍历 - 使用
for就能够实现迭代遍历
# for 循环内部使用的变量 in 列表for name in name_list:
循环内部针对列表元素进行操作 print(name)6、元组
(一)元组的定义
1.**Tuple(元组)**与列表类似,区别:元组的 元素不能修改
元组 表示多个元素组成的序列 元组 在 Python 开发中,有特定的应用场景
2.用于存储 一串 信息,数据 之间使用 , 分隔
3.元组用 () 定义
4.元组的 索引 从 0 开始 索引 就是数据在 元组 中的位置编号
元组中 只包含一个元素 时,需要 在元素后面添加逗号
info_tuple = (50, )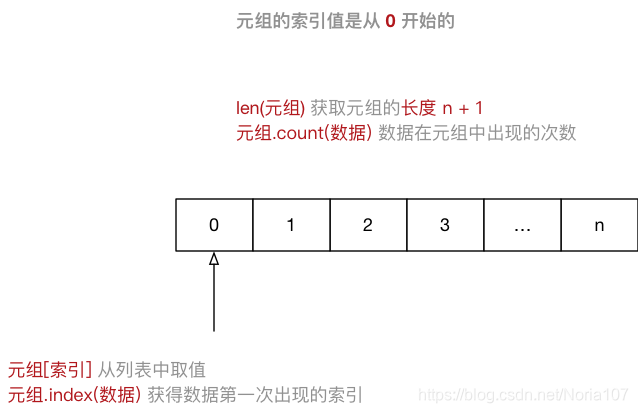
(二)元组常用操作
- 定义一个 元组,eg:
info = ()
(1)循环遍历
- 取值 就是从 元组 中获取存储在指定位置的数据
- 遍历 就是 从头到尾 依次 从 元组 中获取数据
# for 循环内部使用的变量 in 元组在 Python 中,可以使用 for 循环遍历所有非数字型类型的变量:列表、元组、字典 以及 字符串
(2)应用场景
1.尽管可以使用 for in 遍历 元组
2.在开发中应用场景是:
函数的 参数 和 返回值,一个函数可以接收 任意多个参数,或者 一次返回多个数据
3.有关 函数的参数 和 返回值,在后续 函数高级 给大家介绍
格式字符串,格式化字符串后面的 () 本质上就是一个元组
让列表不可以被修改,以保护数据安全
info = ("zhangsan", 18)
print("%s 的年龄是 %d" % info)(三)元组和列表之间的转换
使用 list 函数可以把元组转换成列表
list(元组)使用 tuple 函数可以把列表转换成元组
tuple(列表)7、字典
(一)字典的定义
1.dictionary(字典) 是 除列表以外 Python 之中 最灵活 的数据类型
2.字典同样可以用来 存储多个数据 通常用于存储 描述一个 物体 的相关信息
3.和列表的区别 列表 是 有序 的对象集合 字典 是 无序 的对象集合
4.字典用 {} 定义
5.字典使用 键值对 存储数据,键值对之间使用 , 分隔 键 key 是索引 值 value 是数据 键 和 值 之间使用 : 分隔 键必须是唯一的 值 可以取任何数据类型,但 键 只能使用 字符串、数字或 元组
xiaoming = {"name": "小明", "age": 18, "gender": True, "height": 1.75}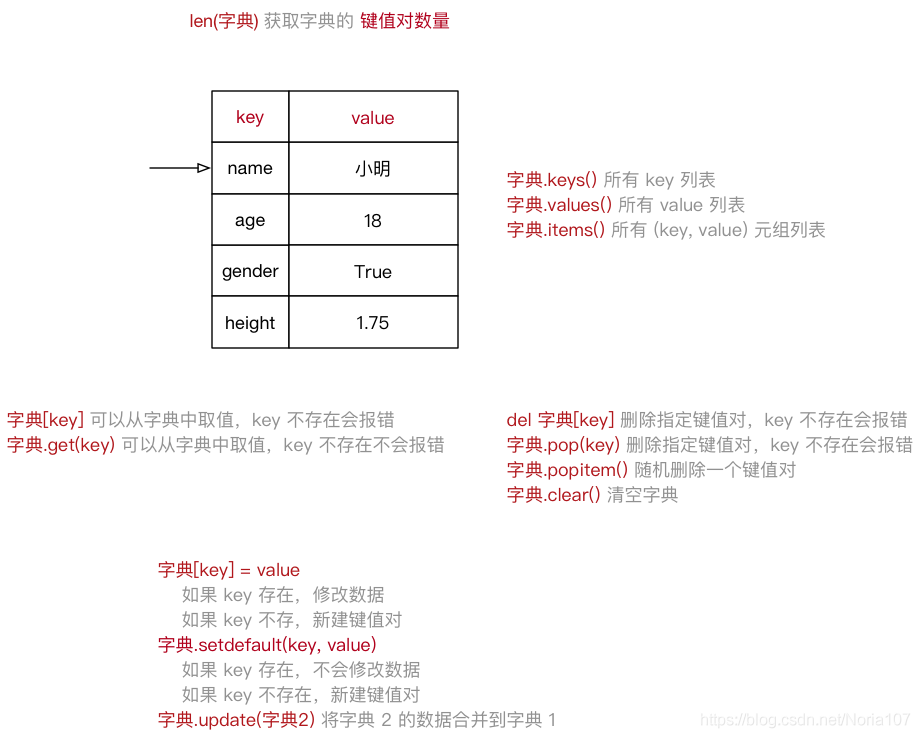
(二)字典常用操作
- 定义一个 字典
zidian = {}常用操作在上图
(三)循环遍历
- 遍历 就是 依次 从 字典 中获取所有键值对
# for 循环内部使用的 `key 的变量` in 字典for k in xiaoming:
print("%s: %s" % (k, xiaoming[k]))8、判断语句(if)
(一)基本语法
if 要判断的条件: 条件成立时,要做的事情 ……注:
if语句以及缩进部分是一个 完整的代码块
(二)else 处理条件不满足的情况
格式如下:
if 要判断的条件: 条件成立时,要做的事情 ……else: 条件不成立时,要做的事情 ……注:
if和else语句以及各自的缩进部分共同是一个 完整的代码块
(三)逻辑运算
- 通常 在判断条件时,会需要同时判断多个条件
- 只有多个条件都满足,才能够执行后续代码
- 逻辑运算符 可以把 多个条件 按照 逻辑 进行 连接,变成 更复杂的条件
- Python 中的 逻辑运算符 包括:与 and/或 or/非 not 三种
(1) and
条件1 and 条件2- 与/并且
- 两个条件同时满足,返回
True - 只要有一个不满足,就返回
False
(2) or
条件1 or 条件2- 或/或者
- 两个条件只要有一个满足,返回
True - 两个条件都不满足,返回
False
(3) not
not 条件- 非/不是
(四)if语句进阶
(1)elif
语法格式如下:
if 条件1: 条件1满足执行的代码 ……elif 条件2: 条件2满足时,执行的代码 ……elif 条件3: 条件3满足时,执行的代码 ……else: 以上条件都不满足时,执行的代码 ……对比逻辑运算符的代码
if 条件1 and 条件2: 条件1满足 并且 条件2满足 执行的代码 ……注:
elif和else都必须和if联合使用,而不能单独使用- 可以将
if、elif和else以及各自缩进的代码,看成一个 完整的代码块
(2)if 嵌套
- 语法格式如下:
if 条件 1: 条件 1 满足执行的代码 ……
if 条件 1 基础上的条件 2: 条件 2 满足时,执行的代码 ……
# 条件 2 不满足的处理 else: 条件 2 不满足时,执行的代码
# 条件 1 不满足的处理else: 条件1 不满足时,执行的代码 ……(3)随机数的处理
- 要使用随机数,先导入 随机数 的 模块 —— “工具包”
import random #引入随机数random模块包- 导入模块后,可以直接在 模块名称 后面敲一个
.然后按Tab键,会提示该模块中包含的所有函数 random.randint(a, b),返回[a, b]之间的整数,包含a和b
random.randint(12, 20) # 生成的随机数n: 12 <= n <= 20
random.randint(20, 20) # 结果永远是 20
random.randint(20, 10) # 错误,下限必须小于上限9、while循环
(一)while循环
初始条件设置 —— 通常是重复执行的 计数器
while 条件(判断 计数器 是否达到 目标次数): 条件满足时,做的事情1 条件满足时,做的事情2 条件满足时,做的事情3 ...(省略)...
处理条件(计数器 + 1)注意:
while语句以及缩进部分是一个 完整的代码块
注意:循环结束后,之前定义的计数器条件的数值是依旧存在的
(二)for循环
-
语法:
for 变量 in 集合:循环体代码else:没有通过 break 退出循环,循环结束后,会执行的代码应用场景
- 在 迭代遍历 嵌套的数据类型时,例如 一个列表包含了多个字典
- 需求:要判断 某一个字典中 是否存在 指定的 值
- 如果 存在,提示并且退出循环
- 如果 不存在,在 循环整体结束 后,希望 得到一个统一的提示
(三)Python 中的计数方法
常见的计数方法有两种:
- 自然计数法(从
1开始)—— 更符合人类的习惯 - 程序计数法(从
0开始)—— 几乎所有的程序语言都选择从 0 开始计数
因此除非需求的特殊要求,否则 循环 的计数都从 0 开始
(四)循环计算
在程序开发中,通常会遇到 利用循环 重复计算 的需求
遇到这种需求,可以:
- 在
while上方定义一个变量,用于 存放最终计算结果 - 在循环体内部,每次循环都用 最新的计算结果,更新 之前定义的变量
(五)break 和 continue
break 和 continue 是专门在循环中使用的关键字
break某一条件满足时,退出循环,不再执行后续重复的代码continue某一条件满足时,不执行后续重复的代码(容易出现死循环)
break 和 continue 只针对 当前所在循环 有效
循环也可以嵌套
10、函数
(一)函数基础
- 函数:将 具有独立功能的代码块 封装为一个小模块,在需要时 调用
- 函数的使用包含两个步骤(先封装、后使用):
- 定义函数 —— 封装 独立的功能
- 调用函数 —— 享受 封装 的成果
- 函数的作用 :提高编写的效率以及代码的 重复使用
(二)函数基本使用
(1)函数的定义
定义函数格式:
def 函数名(): 函数封装的代码 ……-
def是英文define的缩写 -
函数名称 应该能够表达 函数封装代码 的功能,便于后续调用
-
函数名称
的命名应该
符合
标识符的命名规则
- 由 字母、下划线 和 数字 组成
- 不能以数字开头
- 不能与关键字重名
(2)函数调用
调用函数很简单的,通过 函数名() 即可完成对函数的调用
- 定义完成之后,若不主动调用函数,则函数是不会主动执行的
(三)函数的参数
(1)参数的使用
- 在函数名的后面的小括号内部填写 参数
- 多个参数之间使用
,分隔
(2)参数的作用
- 函数的参数,增加函数的 通用性,针对 相同的数据处理逻辑,能够适应更多的数据
- 在函数 内部,把参数当做 变量 使用,进行需要的数据处理
- 函数调用时,按照函数定义的参数顺序,把 希望在函数内部处理的数据,通过参数 传递
(3)形参和实参
- 形参:定义 函数时,小括号中的参数,用于接收参数,在函数内部 作为变量使用
- 实参:调用 函数时,小括号中的参数,将数据传递到 函数内部
(四)函数的返回值
- 返回值 是函数 完成工作后,返回 给调用者的 结果
- 在函数中使用
return关键字可以返回结果 - 调用函数一方,可以 使用变量 来 接收 函数的返回结果
注意:
return表示返回,后续的代码都不会被执行return 的作用:
返回一个对象
阻断代码执行
(五)使用模块中的函数
1.模块 就好比是 工具包,要想使用这个工具包中的工具,就需要 导入 import 这个模块
2.每一个以扩展名 py 结尾的 Python 源代码文件都是一个 模块
3.在模块中定义的 全局变量 、 函数 都是模块能够提供给外界直接使用的工具
4.可以 在一个 Python 文件 中 定义 变量 或者 函数
5.然后在 另外一个文件中 使用 import 导入这个模块
6.导入之后,就可以使用 模块名.变量 / 模块名.函数 的方式,使用这个模块中定义的变量或者函数
模块名也是一个标识符
- 标示符可以由 字母、下划线 和 数字 组成
- 不能以数字开头
- 不能与关键字重名
(六)函数进阶
(1)函数参数和返回值的作用
- 如果函数 内部处理的数据不确定,就可以将外界的数据以参数传递到函数内部
- 如果希望一个函数 执行完成后,向外界汇报执行结果,就可以增加函数的返回值
1、无参数,无返回值
此类函数,不接收参数,也没有返回值,应用场景如下:
- 只是单纯地做一件事情,例如 显示菜单
- 在函数内部 针对全局变量进行操作,例如:新建名片,最终结果 记录在全局变量 中
注:
- 如果全局变量的数据类型是一个 可变类型,在函数内部可以使用 方法 修改全局变量的内容 —— 变量的引用不会改变
- 在函数内部,使用赋值语句 才会 修改变量的引用
2、无参数,有返回值
此类函数,不接收参数,但是有返回值,应用场景如下:
- 采集数据,例如 温度计,返回结果就是当前的温度,而不需要传递任何的参数
3、有参数,无返回值
此类函数,接收参数,没有返回值,应用场景如下:
- 函数内部的代码保持不变,针对 不同的参数 处理 不同的数据
4、有参数,有返回值
此类函数,接收参数,同时有返回值,应用场景如下:
- 函数内部的代码保持不变,针对 不同的参数 处理 不同的数据,并且 返回期望的处理结果
(2)函数的返回值 进阶
-
在程序开发中,有时候,会希望 一个函数执行结束后,告诉调用者一个结果,以便调用者针对具体的结果做后续的处理
-
返回值 是函数 完成工作后,最后 给调用者的 一个结果
-
在函数中使用
return关键字可以返回结果 -
调用函数一方,可以 使用变量 来 接收 函数的返回结果
提示:如果一个函数返回的是元组,括号可以省略
技巧
- 在
Python中,可以 将一个元组 使用 赋值语句 同时赋值给 多个变量 - 注意:变量的数量需要和元组中的元素数量保持一致
result = temp, wetness = measure()(七)函数的参数 进阶
(1)不可变和可变的参数
-
无论传递的参数是
可变
还是
不可变
- 只要 针对参数 使用 赋值语句,会在 函数内部 修改 局部变量的引用,不会影响到 外部变量的引用
1、缺省参数
- 定义函数时,给 某个参数 指定一个默认值,具有默认值的参数就叫做 缺省参数
- 调用函数时,如果没有传入 缺省参数 的值,则在函数内部使用定义函数时指定的 参数默认值
- 函数的缺省参数,将常见的值设置为参数的缺省值,从而 简化函数的调用
2、指定函数的缺省参数
- 在参数后使用赋值语句,可以指定参数的缺省值
提示
- 缺省参数,需要使用 最常见的值 作为默认值!
- 如果一个参数的值 不能确定,则不应该设置默认值,具体的数值在调用函数时,由外界传递!
3、缺省参数的注意事项
1) 缺省参数的定义位置
- 必须保证 带有默认值的缺省参数 在参数列表末尾
2) 调用带有多个缺省参数的函数
- 在 调用函数时,如果有 多个缺省参数,需要指定参数名,这样解释器才能够知道参数的对应关系!
(2)多值参数
1、定义支持多值参数的函数
- 有时可能需要 一个函数 能够处理的参数 个数 是不确定的,这个时候,就可以使用 多值参数
python中有 两种 多值参数:- 参数名前增加 一个
*可以接收 元组 如:*args - 参数名前增加 两个
*可以接收 字典 如:**kwargs
- 参数名前增加 一个
2、元组和字典的拆包
- 在调用带有多值参数的函数时,如果希望:
- 将一个 元组变量,直接传递给
args - 将一个 字典变量,直接传递给
kwargs
- 将一个 元组变量,直接传递给
- 就可以使用 拆包,简化参数的传递,拆包 的方式是:
- 在 元组变量前,增加 一个
* - 在 字典变量前,增加 两个
*
- 在 元组变量前,增加 一个
(八)函数的递归
函数调用自身的 编程技巧 称为递归
递归函数的特点
- 一个函数 内部 调用自己
代码特点
-
函数内部的 代码 是相同的,只是针对 参数 不同,处理的结果不同
-
当
参数满足一个条件
时,函数不再执行
- 非常重要,通常被称为递归的出口,否则 会出现死循环!
11、其他
(一)print函数
- 在默认情况下,
print函数输出内容之后,会自动在内容末尾增加换行 - 如果不希望末尾增加换行,可以在
print函数输出内容的后面增加, end="" - 其中
""中间可以指定print函数输出内容之后,继续希望显示的内容 - 语法格式如下:
# 向控制台输出内容结束之后,不会换行print("*", end="")
# 单纯的换行print("")end="" 表示向控制台输出内容结束之后,不会换行
假设 Python 没有提供 字符串的 * 操作 拼接字符串
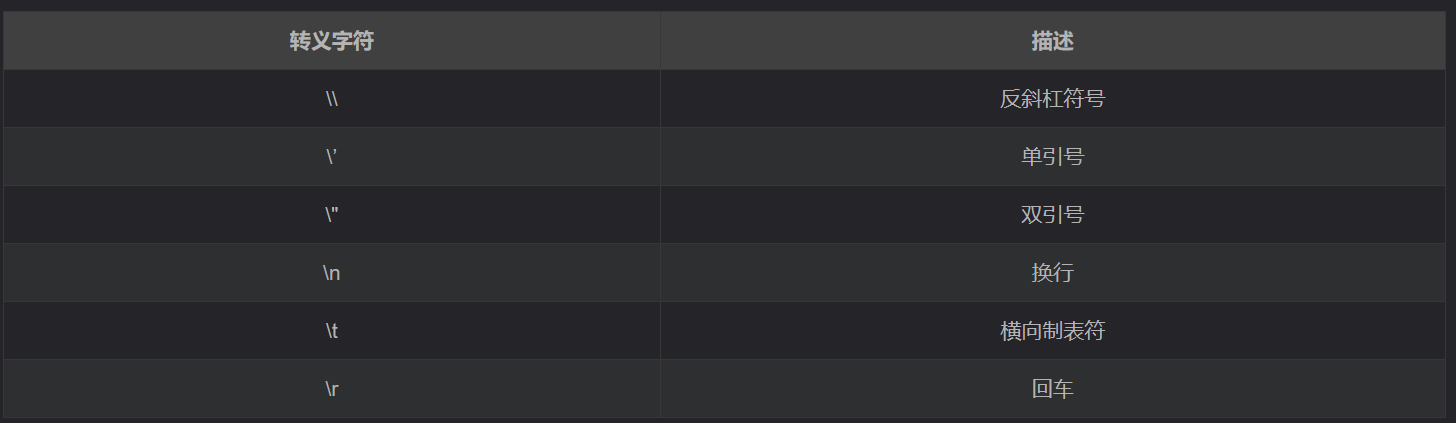
字符串中的转义字符
\t在控制台输出一个 制表符,协助在输出文本时 垂直方向 保持对齐\n在控制台输出一个 换行符
制表符 的功能是在不使用表格的情况下在 垂直方向 按列对齐文本
(二)注释
- 单行注释(行注释):使用#
- 多行注释(块注释):使用"" … “”
(三)公共方法
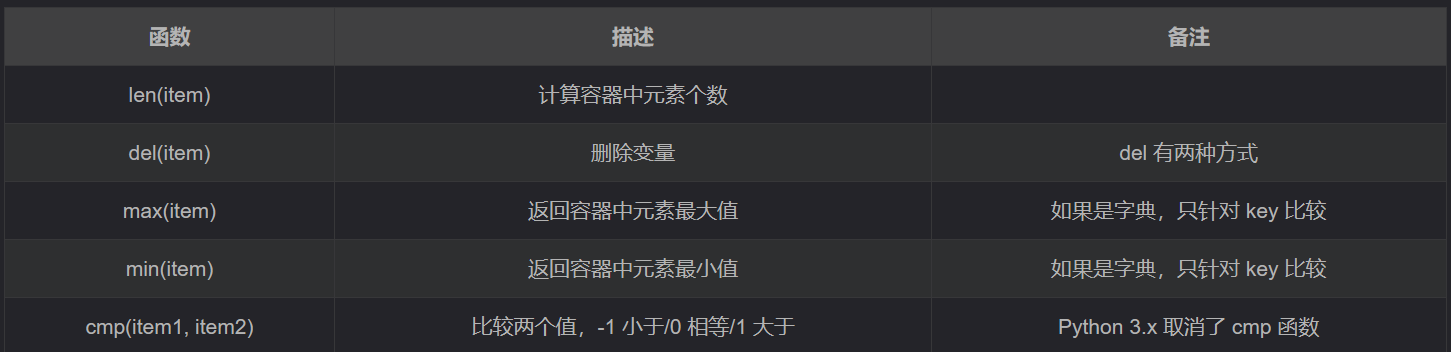
(1)Python 内置函数
Python 包含了以下内置函数:
注意
- 字符串 比较符合以下规则: “0” < “A” < “a”
(2)切片

- 切片 使用 索引值 来限定范围,从一个大的 字符串 中 切出 小的 字符串
- 列表 和 元组 都是 有序 的集合,都能够 通过索引值 获取到对应的数据
- 字典 是一个 无序 的集合,是使用 键值对 保存数据
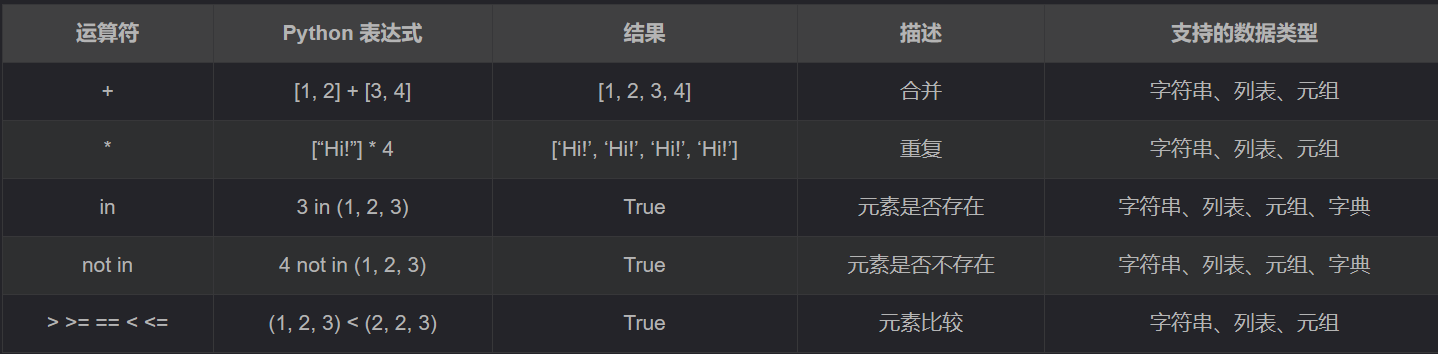
(3)运算符
注意
in在对 字典 操作时,判断的是 字典的键in和not in被称为 成员运算符
(4)成员运算符
成员运算符用于 测试 序列中是否包含指定的 成员
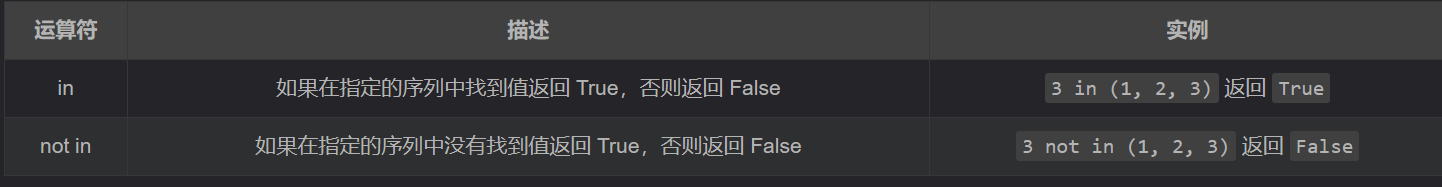
注意:在对 字典 操作时,判断的是 字典的键
12、上课代码
#print()
# print('hello,world~')# print(123)# print(12.3)
# print('hello',end=' ')# print('world')
# print(1,2,3,4,5,sep=':')
#变量
# a=1# b=2# print(a)# print(b)
# a=10# b=20# c=0# print(a,b)# c=a# a=b# b=c# print(a,b)# a,b=b,a# print(a,b)
#数据类型
#Number ,string ,列表list,集合set,元组tuple,字典dict
# a=1# print(a)# print(type(a))
# from decimal import Decimal# n1=1.1# n2=2.2# print(Decimal('1.1')+Decimal('2.2'))# print(type(n1))# print(n1+n2)
# print(1+True)# print(1+False)
# '' 单行字符串
# " " 通常表示句子
# '''
# ''' 段落
# """
# """ 段落
# str='xiaoming'# str2="this is my world!"# str3='''# 小红
# 小兰# 小绿# '''# print(str)# print(str2)# print(str3)
#数据类型转换
# str(),int(),float(),bool()
# a=123# print('a变量的类型:',type(a))# b=str(a)# print('b变量的类型',type(b))# c=int(b)# print('c变量的类型:',type(c))# d=float(c)# print('d变量的类型:',type(d))# e=bool(d)# print('e变量的类型:',type(e))
#进制转换
# print(11) #十进制# print(0b11) #二进制# print(0o11) #八进制# print(0x11) #十六进制
# print(bin(3))# print(oct(9))# print(hex(17))
# print(ord('a'))# print(chr(97))
# + - * / % 5%2 == 1# ** 乘方
# a=2# b=3# c=a**b# print(c)
# print('hello,\nworld')# print('hello,\\nworld') #转译# print(r'he\nllo,\nworld') #全部转译
# #\r 将光标移到本行开头# a=10# b='小明'# print(f'我朋友{b}今年胖了{a}斤')
# import time
# for i in range(6): #0-5# print(f'\r你的节操掉了{5-i}斤')# time.sleep(1)
# a=input("请输入您的姓名")# print(a)# print(type(a))
# age=int(input("请输入您的年龄"))# print(age)# print(type(age))
#切片
#高级索引,用的比较多
#变量[头下标:尾下标:步长]
# str='123456789'# print(str)# print(str[0])# print(str[2:5]) # 左闭右开[2,5)# print(str[0:-1]) #左闭右开[0,8]# print(str[3:])# print(str[1:5:2])# print(str[1::2])# print(str[::2])# print(str[::-1])
# 列表 [] list# 集合 {} set# 元素 () tuple# 字典 {} dict
# 1.列表:可以重复,可以修改,购物车信息# 2.集合:可以修改,但是不能重复。无序的。记录兴趣爱好等数据。打篮球# 3.元组:创建完就无法改变。安全性高一些# 4.字典:键和值。学校系统,记录学生信息。学号:学生其他信息。
# a = []# print(type(a))
a = [1,2,3,4,5,6,7,8,9]# print(a)# a[2]='a'# a[3]='a'# a[4]='a'# print(a)# a[2:6] = 'a'# print(a)
# a[3]=[1,2,3]# print(a)# print(a[3][1])
# print(max(a))# a.append(88)# print(a)# print(a.index(8))# print(a.pop())# print(a)# print(a.pop(3))# print(a)# a.remove(2)# print(a)# print(len(a))
#元组
# a=(1,2,3)# print(a)# print(type(a))# print(a[1])# a[1]=99# print(a)
#集合
#可以去除重复# a = {}# print(type(a))# b=set()# print(type(b))# b.add(10)# print(b)
# c={1,2,3,4,5,6,7,8,9}# print(c)# print(type(c))二、爬虫
三、信息收集
一、信息收集介绍
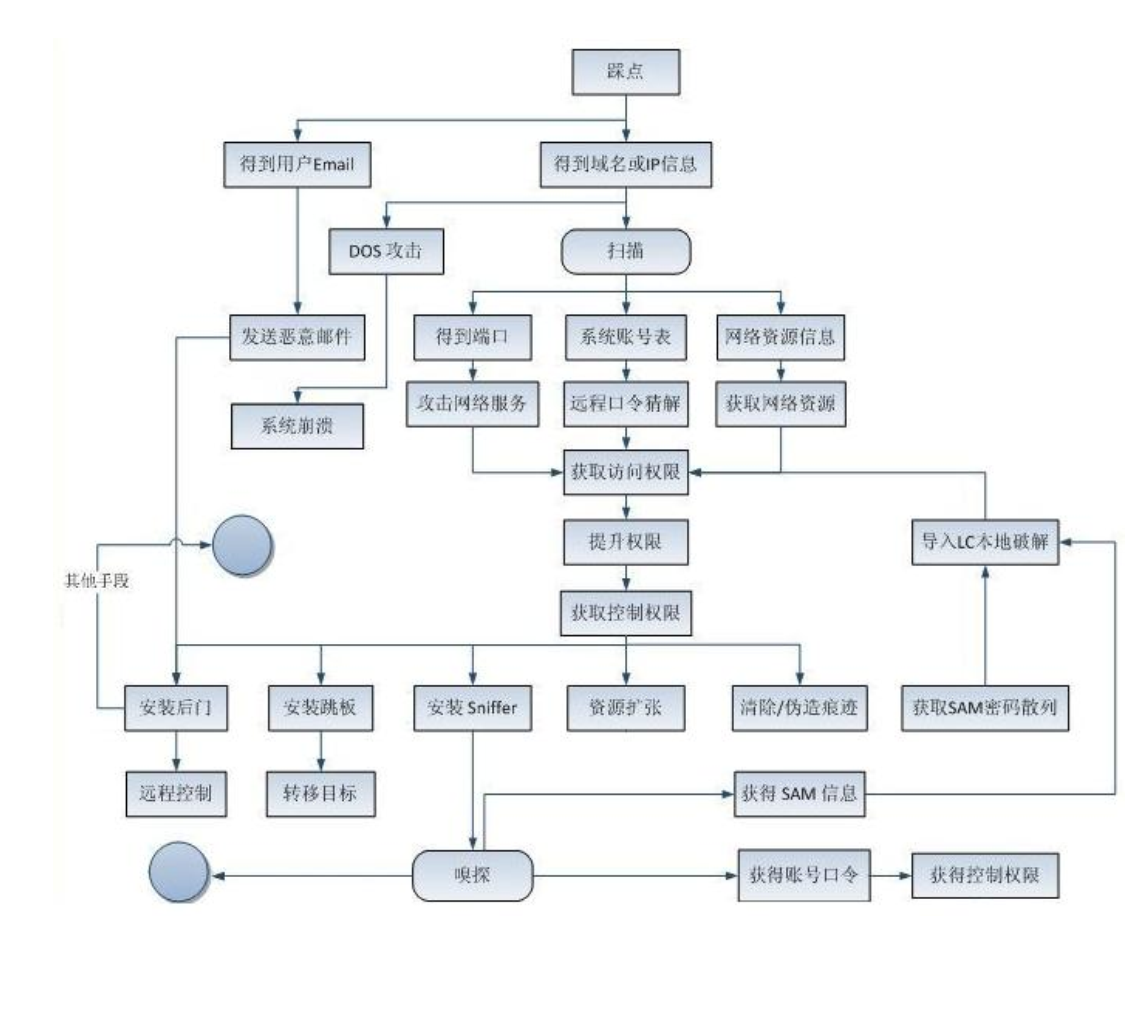
1、信息收集由来——黑客攻击模型
信息收集,俗称踩点。
渗透测试最重要的阶段之一就是信息收集。
为了启动渗透测试,用户需要收集关于目标网络资产等信息。用户得到的信息越多,渗透测试成功的概率也就越高。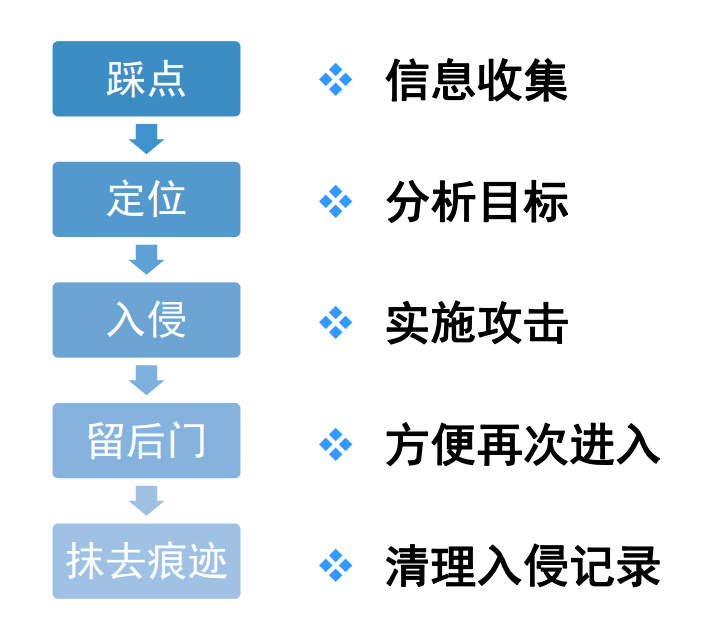
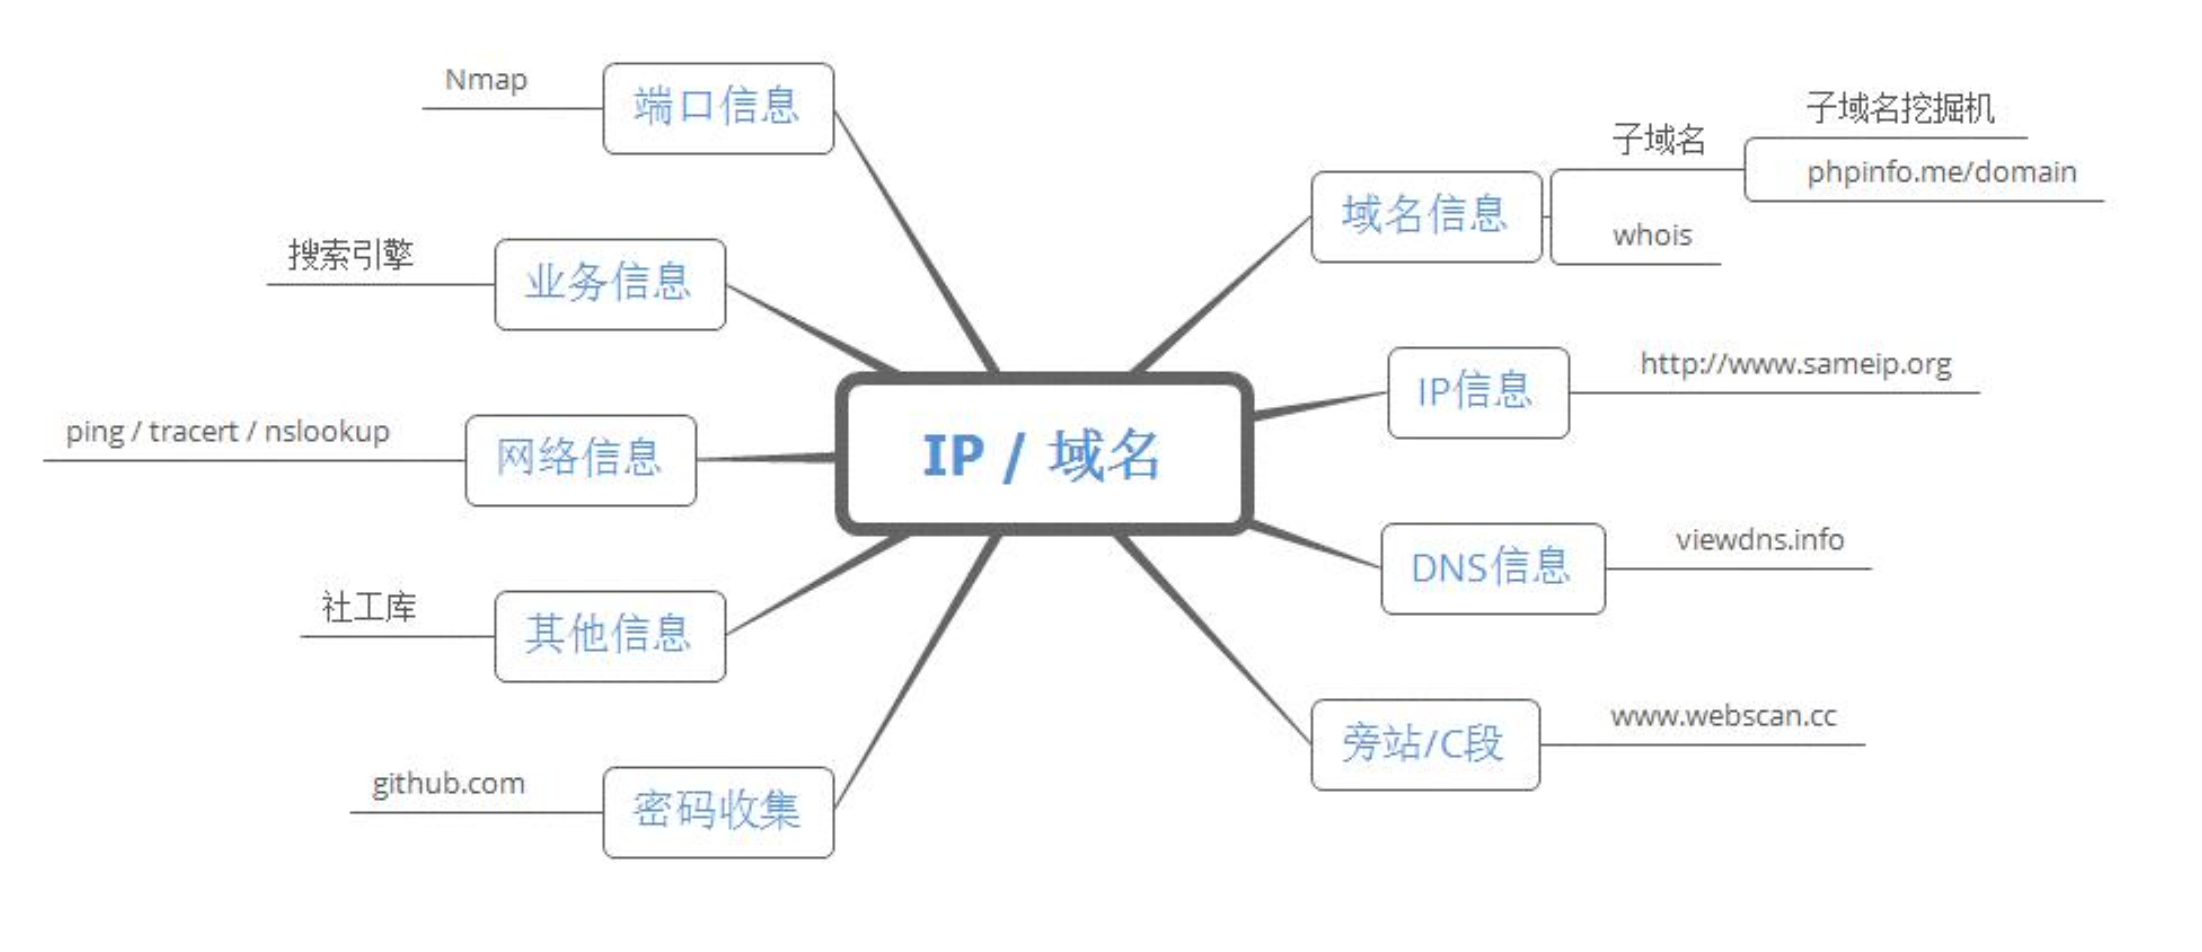
2、信息收集类型
二、信息收集基本方式
1、Whois
whois(读作“Whois”,非缩写)是用来查询域名的IP以及所有者等信息的传输协议。简单说,whois就是一个用来查询域名是否已经被注册,以及注册域名的详细信息的数据库(如域名所有人、域名注册商)。通过whois来实现对域名信息的查询。早期的whois查询多以命令列接口存在,但是现在出现了一些网页接口简化的线上查询工具,可以一次向不同的数据库查询。网页接口的查询工具仍然依赖whois协议向服务器发送查询请求,命令列接口的工具仍然被系统管理员广泛使用。whois通常使用TCP协议43端口。每个域名/IP的whois信息由对应的管理机构保存。
https://whois.chinaz.com/
https://whois.aliyun.com/2、子域名
子域名(或子域;英语:Subdomain)是在域名系统等级中,属于更高一层域的域。比如,mail.example.com和calendar.example.com是example.com的两个子域,而example.com则是顶级域.com的子域。(针对大网站)收集子域名可以很大程度知道目标所拥有的网站等资产信息。
工具:子域名挖掘机3、目录扫描
目录扫描工具主要针对网站目录或者后台管理地址进行暴力猜解的工具。目录扫描工具有一个共同的特性:目录字典或者后台管理字典越强大,其扫描出的目录或者后台管理地址的数目就越多、越准确。以前的目录扫描工具有啊D注入工具(目录扫描模块)等。
目录扫描工具有御剑、dirsearch、DirBuster及wwwscan等。
https://github.com/maurosoria/dirsearch4、旁站C段
查询旁站指某个服务器同一个IP地址所有域名。
查询C段指某个服务器IP地址所在C段IP地址的所有域名。
www.webscan.cc
https://chapangzhan.com/5、征信查询
企业征信机构记录了一家企业的基本信息,历史沿革,股东及出资等信息的平台。
企查查:https://www.qcc.com
天眼查:https://www.tianyancha.com6、DNS查询
获取域名或者IP地址,并进行反向查找以快速显示同一服务器承载的所有其他域。
https://tools.ipip.net/
https://www.dnsdb.io
https://www.ip138.com7、IP地址查询
根据IP地址查询同一IP地址的其他信息。
查询:https://www.ip138.com8、备案号
备案号是网站是否合法注册经营的标志,一个网站域名要上线必然要经过备案程序,通过备案号反查可查询目标的所有合法网站。
查询:
http://icp.chinaz.com/
http://beian.miit.gov.cn9、敏感信息泄露
gitHub是全球最大的面向开源及私有软件项目的托管平台。
许多企业的开发人员在上传开源代码到github往往忽略了将密码等敏感信息删除导致信息泄露。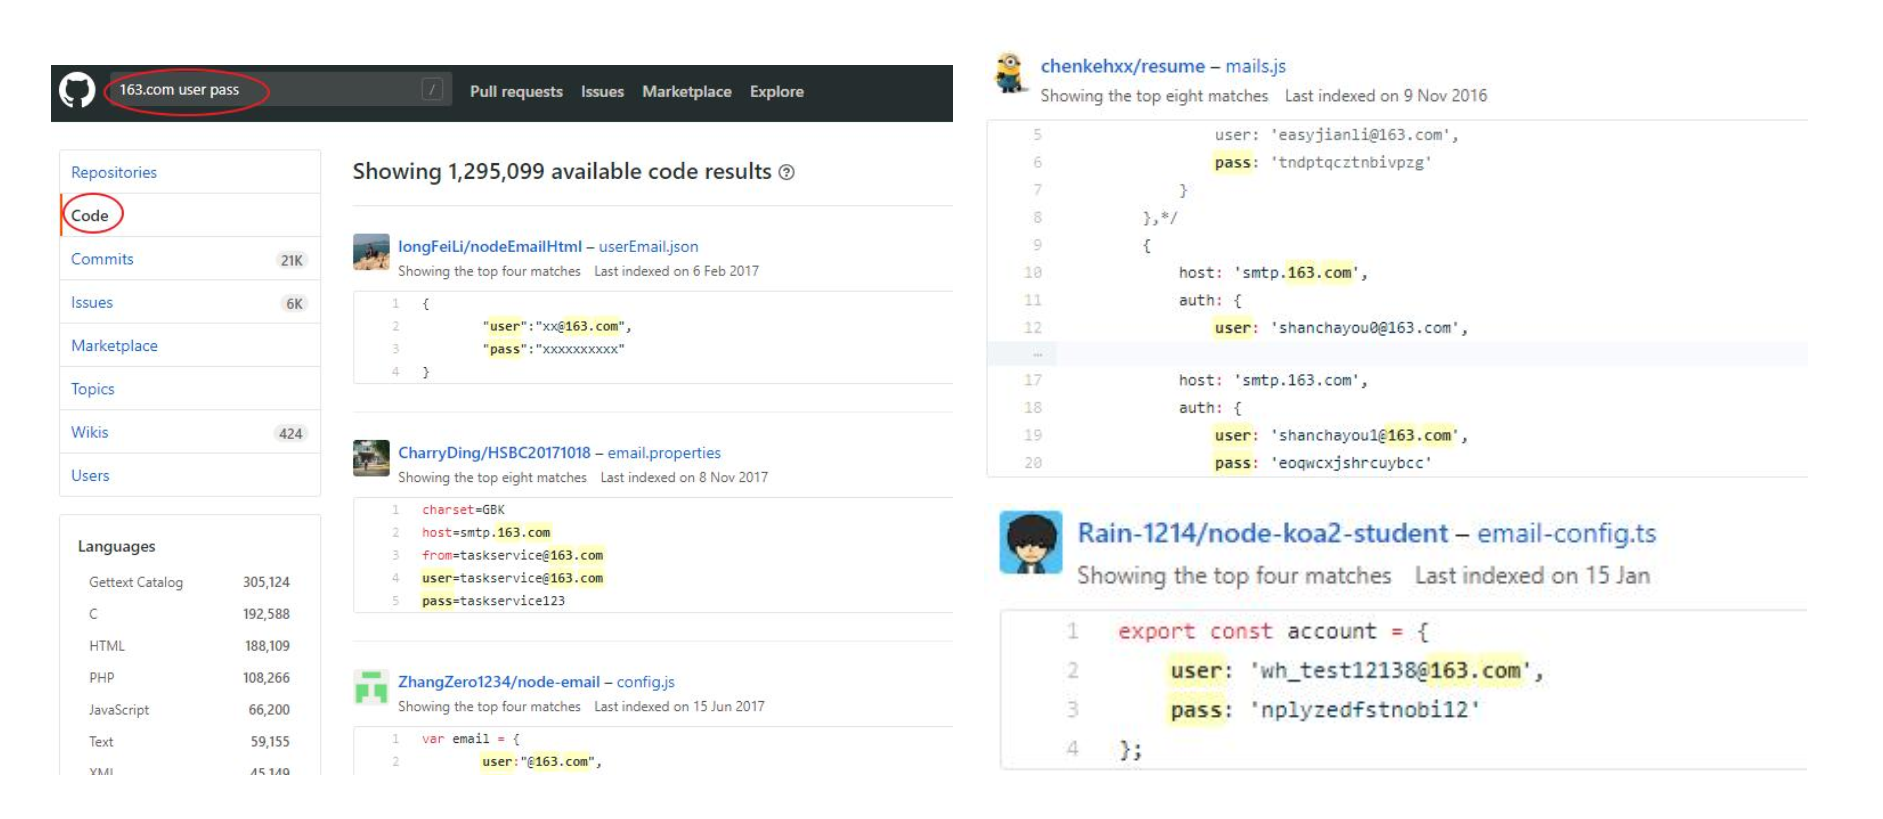
10、JS文件探测
1.JS里能找到啥?
作为一个安全从业人员,我们最关心的就是Js文件中的这些东西:会增加攻击面的信息(URL,域名等)
敏感信息(密码,API密钥,bucket等)
代码中的潜在危险函数操作(eval,dangerallySetInnerHTML等)
2.具有已知漏洞的组件(过时的框架等)怎么去找?
识别并收集应用程序中的JavaScript文件
使收集的JavaScript代码可读(取消最小化/反混淆)识别可能导致安全问题的信息(找敏感词)11、社会工程学
社会工程学:利用心理学、行为学、揣摩、推理外在信息去分析内在信息,获取密码、心理性格、做事习惯,分析漏洞。
三、Google Hacking
1、Google Hacking
GoogleHacking是利用谷歌搜索的强大,来在浩瀚的互联网中搜索到我们需要的信息。轻量级的搜索可以搜素出一些遗留后门,不想被发现的后台入口,中量级的搜索出一些用户信息泄露,源代码泄露,未授权访问等等,重量级的则可能是mdb文件下载,CMS未被锁定install页面,网站配置密码,php远程文件包含漏洞等重要信息。1.基本搜索:
1)逻辑与:and
2)逻辑或:or
3)逻辑非:-
4)完整匹配:“关键词”
5)通配符:*?
2.高级搜索:
1)intext
寻找正文中含有关键字的网页,例如:intext:后台登录将只返回正文中包含后台登录的网页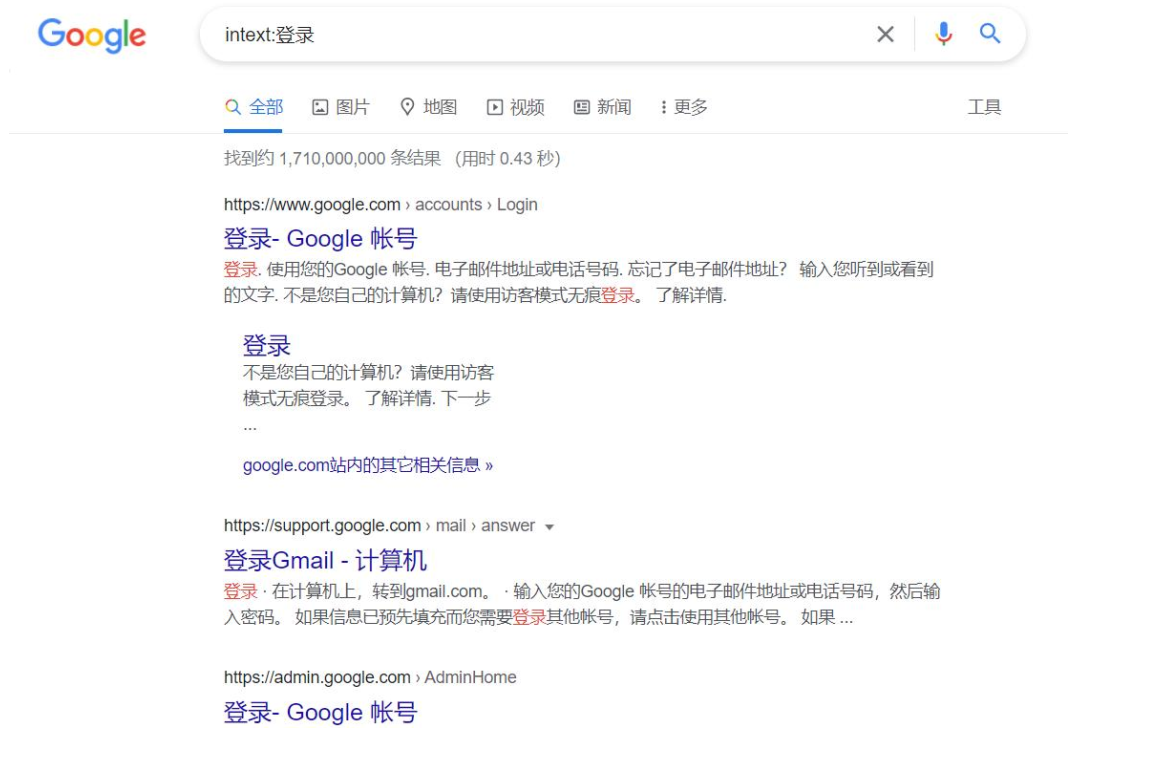
2)intitle
寻找标题中含有关键字的网页,例如:intitle:后台登录将只返回标题中包含后台登录的网页,intitle:后台登录密码将返回标题中包含黑客而正文中包含中国的网页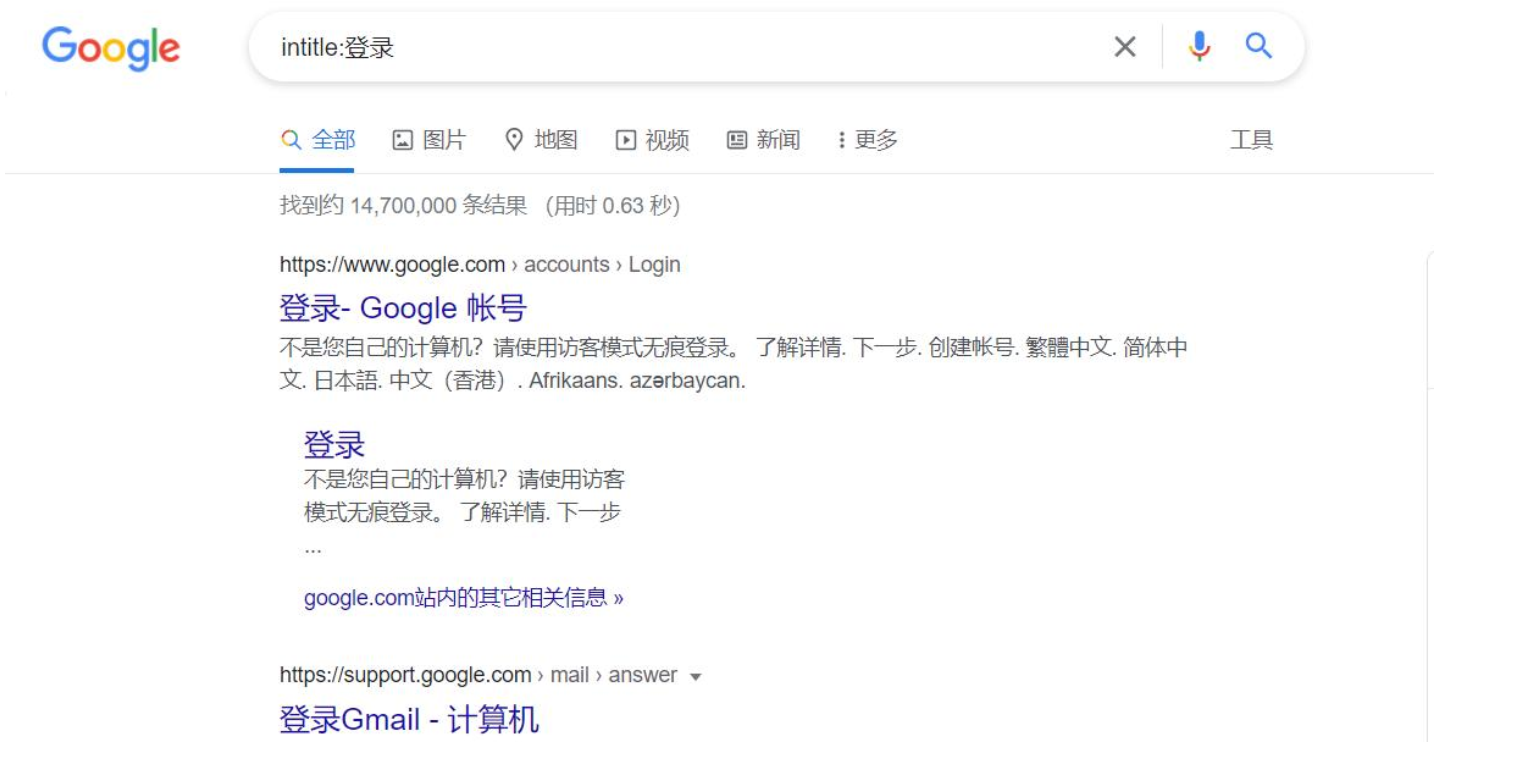
3)alltitle
用法和intitle类似,只不过可以指定多个词,例如:alltitle:后台登录管理员将返回标题中包含后台登录和管理员的网页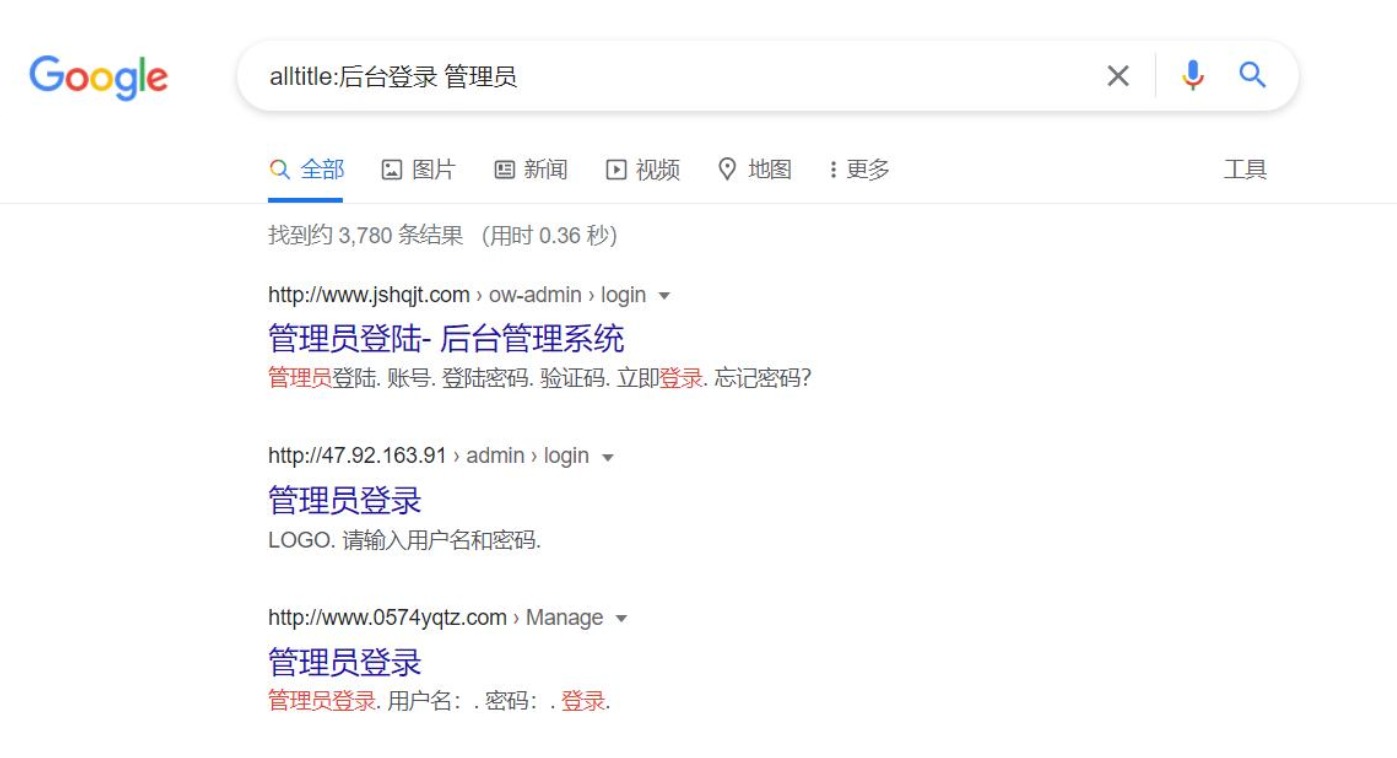
4)inurl
将返回url中含有关键词的网页:例如:inurl:/login.php将返回url中含有Login的网页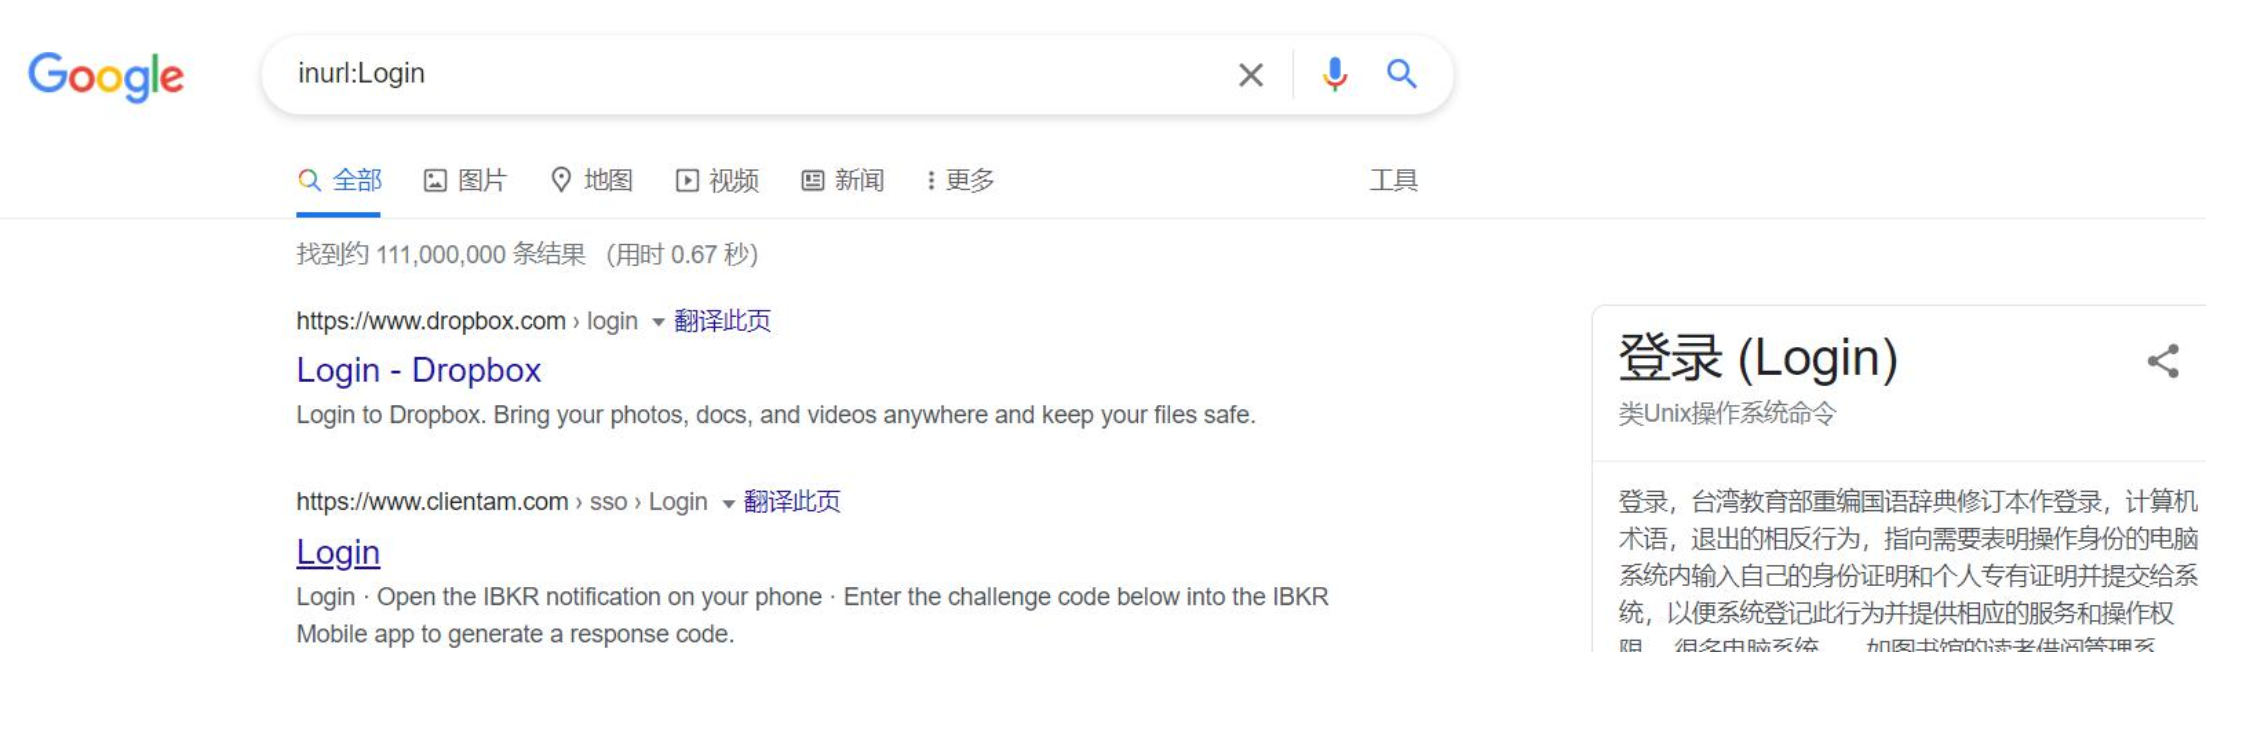
5)site
指定访问的站点,例如:site:baidu.cominurl:Login将只在baidu.com中查找url中含有Login的网页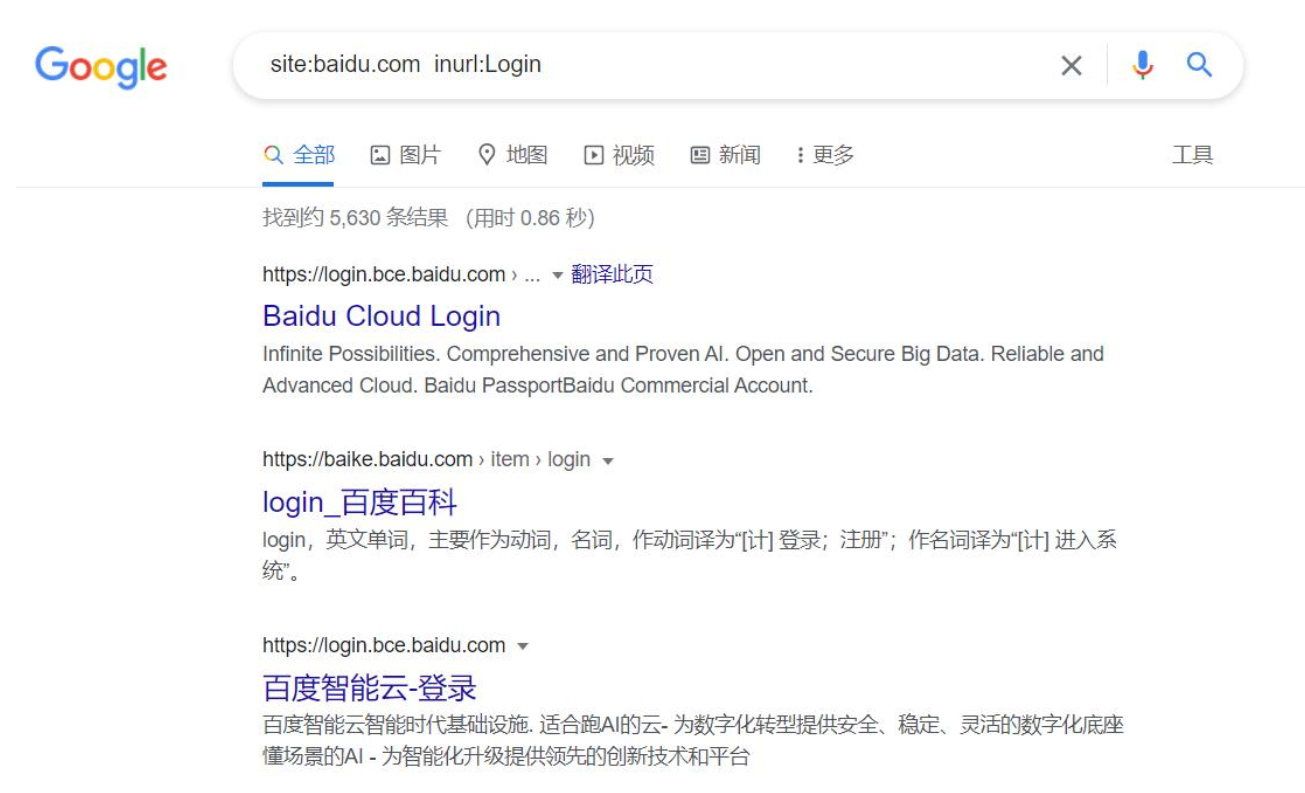
6)filetype
指定访问的文件类型,例如:site:baidu.comfiletype:pdf将只返回baidu.com站点上文件类型为pdf的网页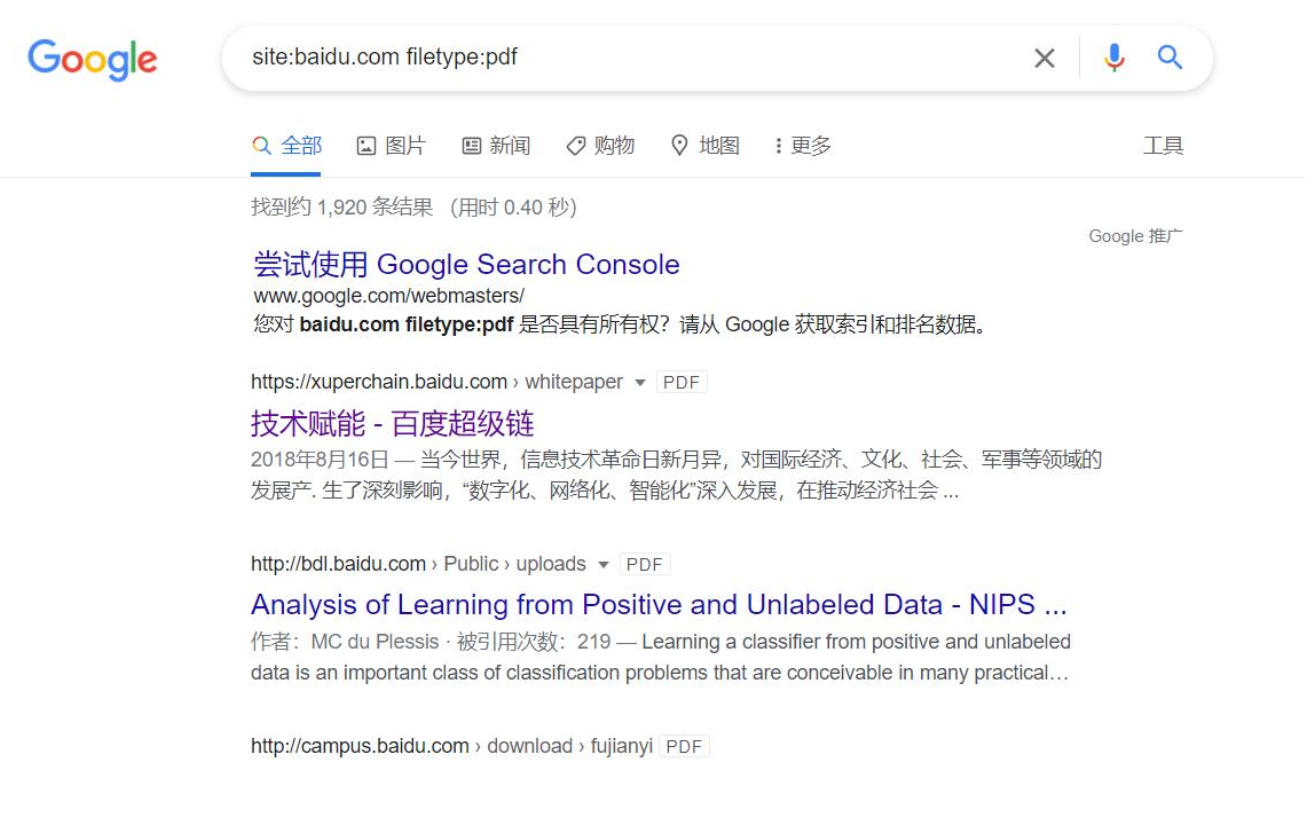
7)link
指定链接的网页,例如:link:www.baidu.com将返回所有包含指向www.baidu.com的网页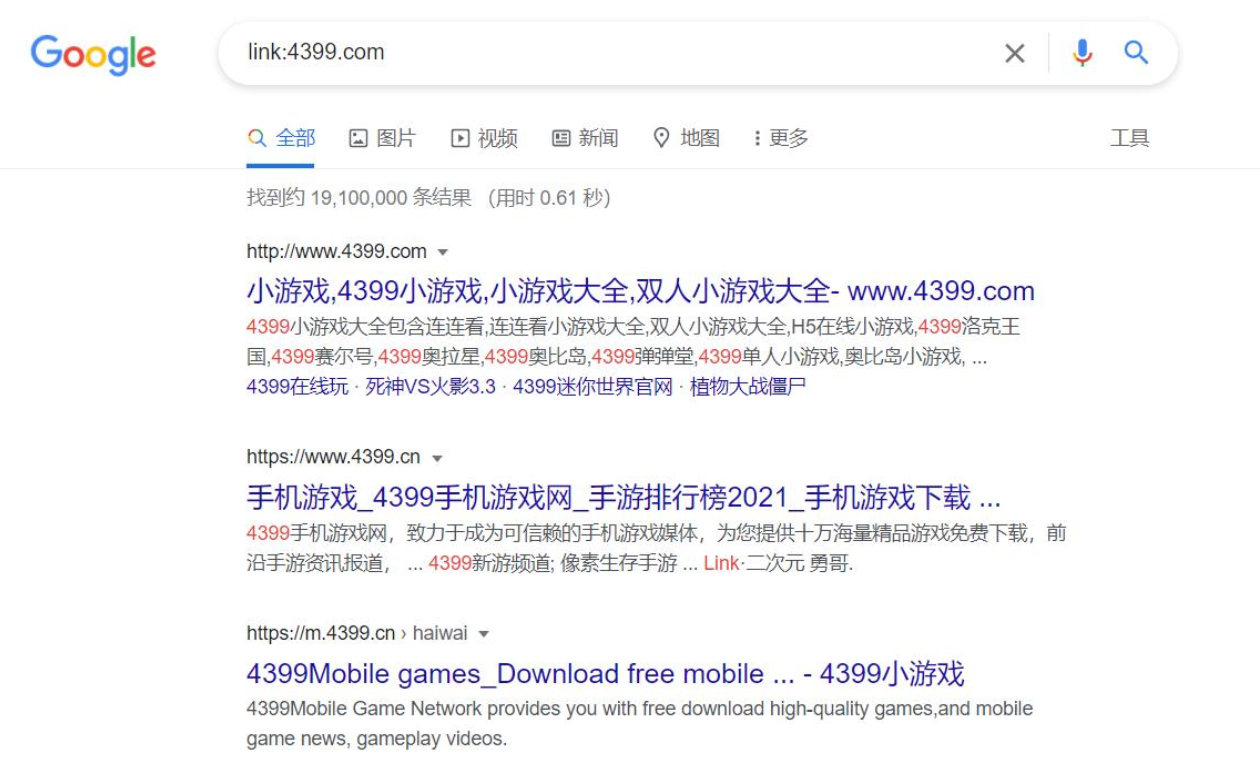
8)related
相似类型的网页,例如:related:www.xjtu.edu.cn将返回与www.xjtu.edu.cn相似的页面,相似指的是网页的布局相似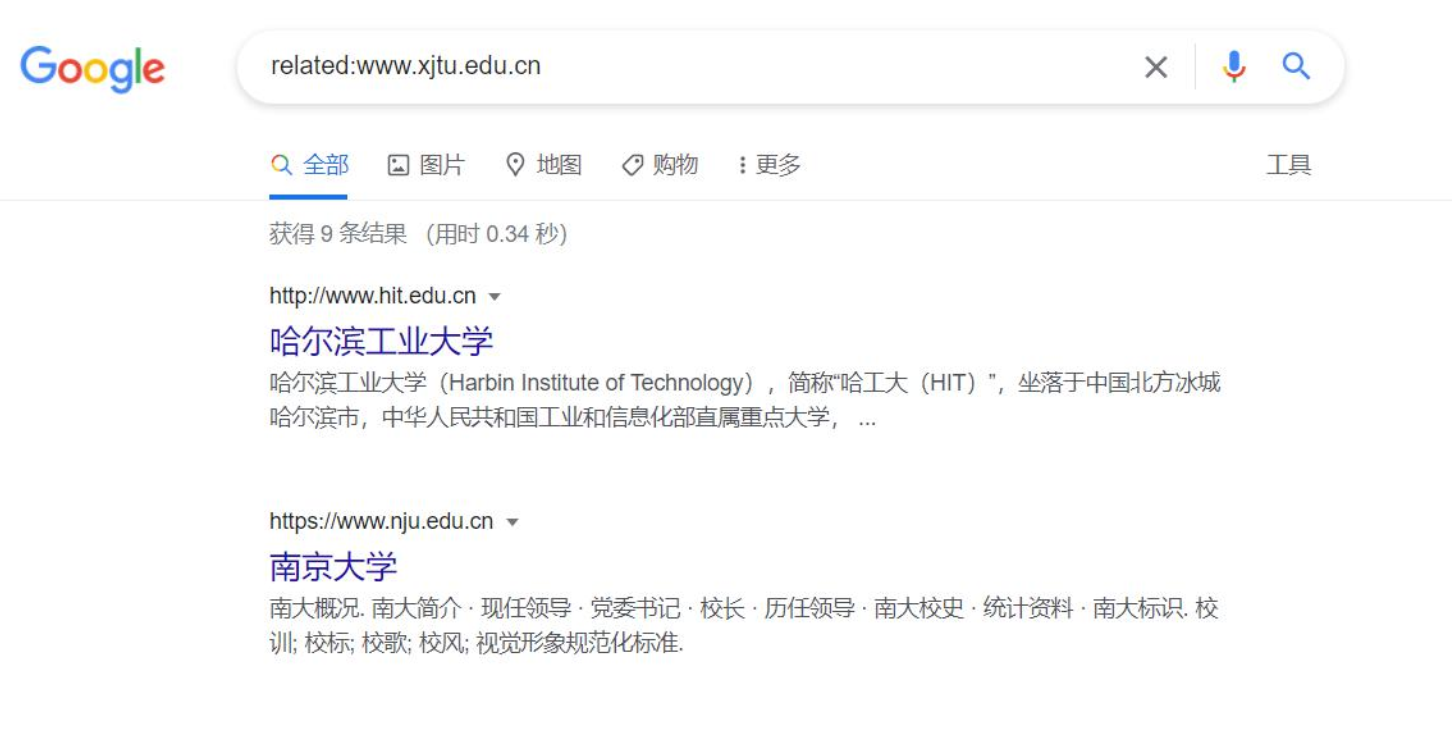
9)cache
网页快照,谷歌将返回给你他存储下来的历史页面,如果你同时制定了其他查询词,将在搜索结果里以高亮显示,例如:cache:www.baidu.comguest,将返回指定网站的缓存,并且正文中含有guest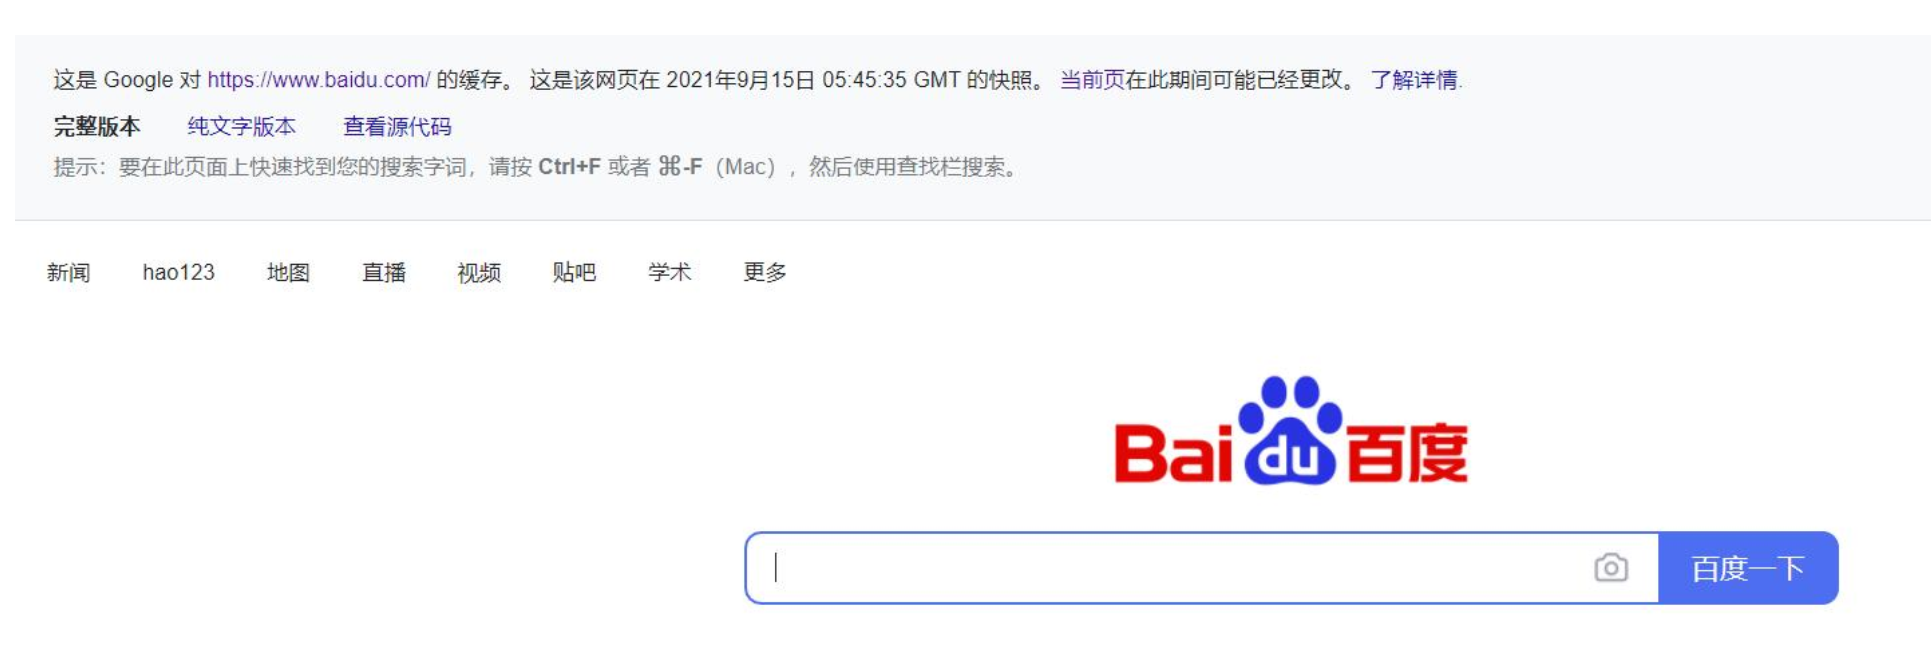
10)info
返回站点的指定信息,例如:info:www.baidu.com将返回百度的一些信息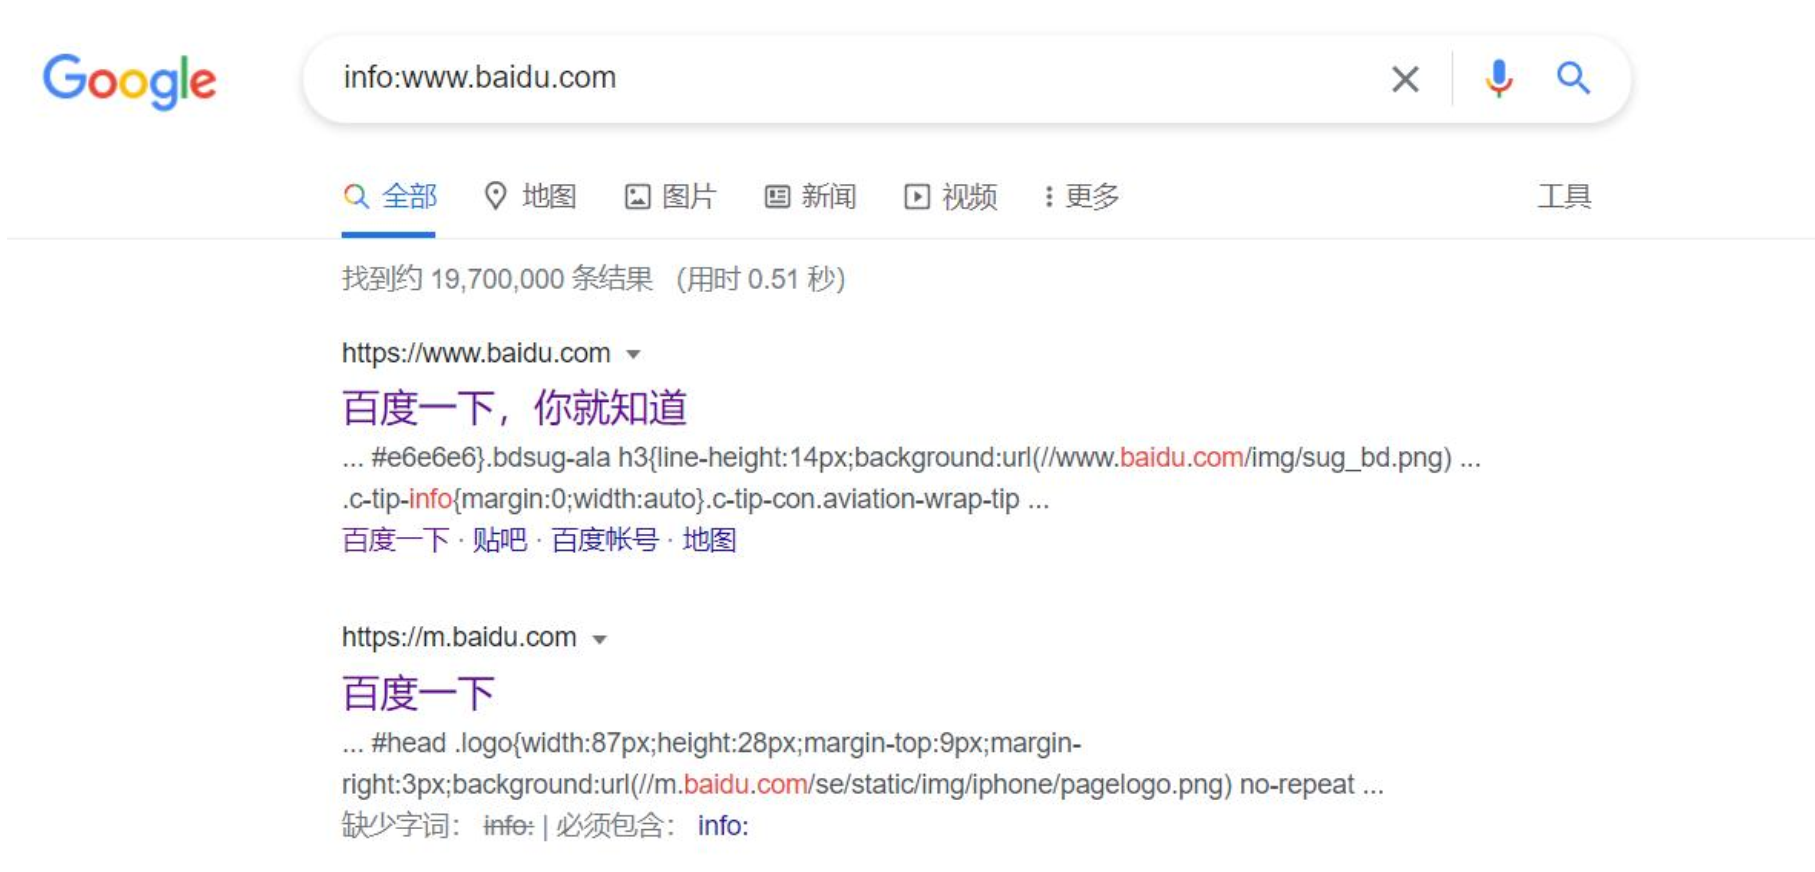
11)define
返回某个词语的定义,例如:define:Hacker将返回关于Hacker的定义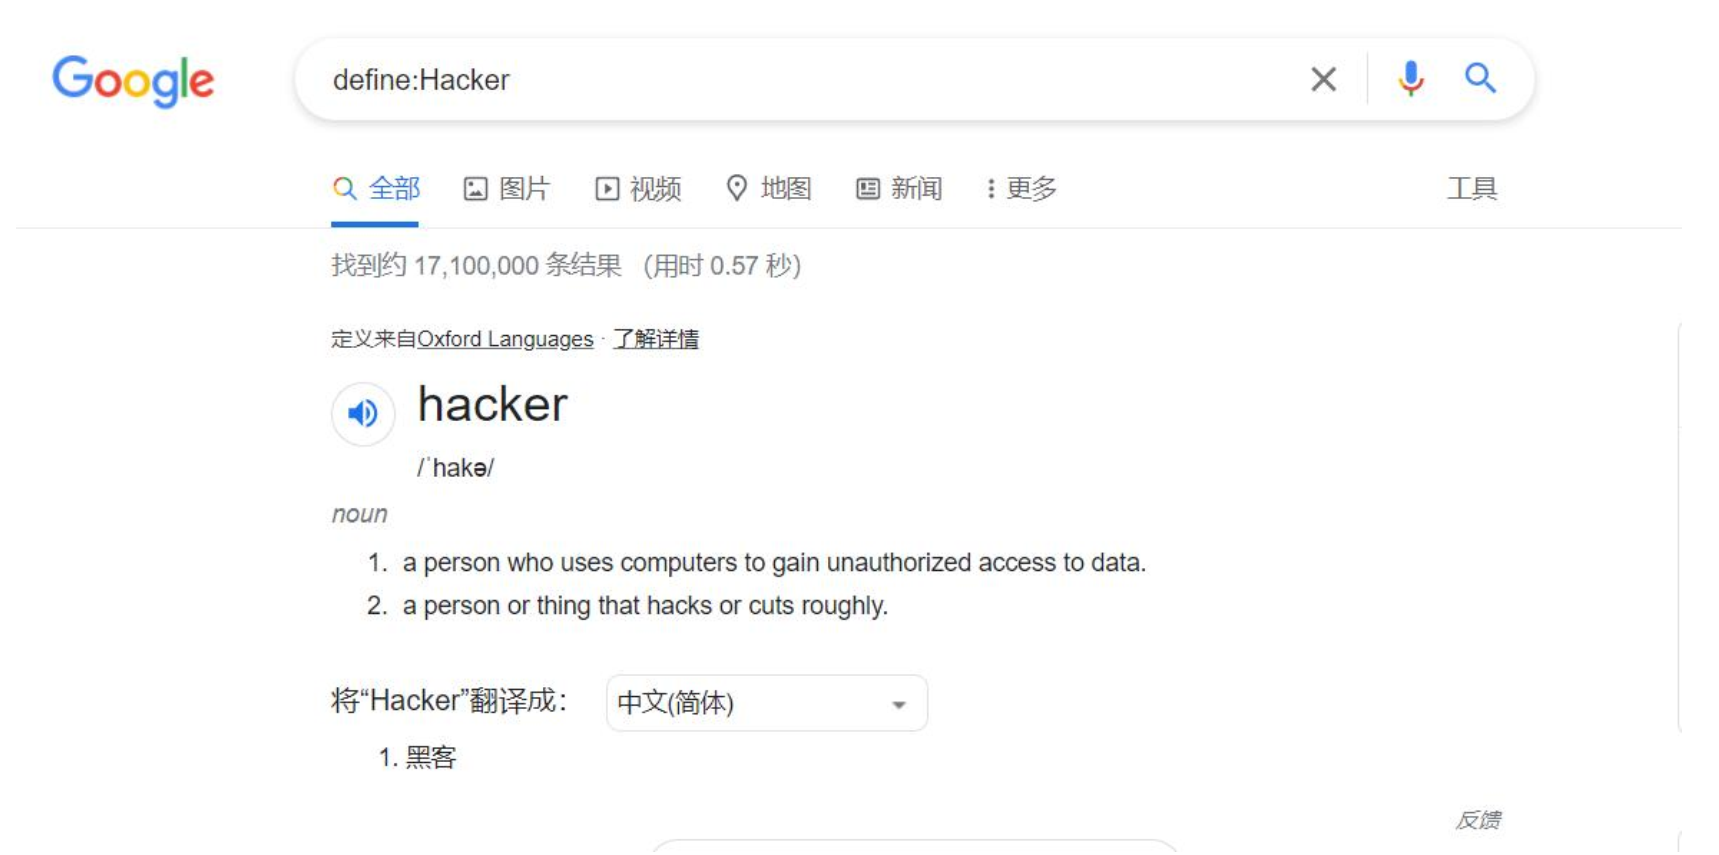
3.常用查询语句
1)查找网站后台
site:xx.comintext:管理
site:xx.cominurl:login
site:xx.comintitle:后台2)查看服务器使用的程序
site:xx.comfiletype:asp
site:xx.comfiletype:php
site:xx.comfiletype:jsp
site:xx.comfiletype:aspx3)查看上传漏洞
site:xx.cominurl:file
site:xx.cominurl:load4.一些有趣的查询
利用Indexof语法去发现允许目录浏览的web网站,就像在本地的普通目录一样。下面是一些有趣的查询:
indexof/admin
indexof/passwd
indexof/password
indexof/mail
"indexof/"+passwd
"indexof/"+password.txt
"indexof/"+.htaccess
"indexof/root"
"indexof/cgi-bin"
"indexof/logs"
"indexof/config"2、CDN绕过
1.多地ping(超级ping)
通过多个地区的服务器去ping,查看ip地址是否是一样的
https://ping.chinaz.com/2.DNS的绑定查询
大部分网站早期可能没有开CDN,则会有dns历史遗留下来。
CDN访问有流量上限,用大量的访问消耗完流量,继续访问就是真实的IP。3.子域名查询
主域名有开CDN,子域名没有开CDN,子域名的IP地址就是这个服务器的真实地址。4.国外ping
大部分用户在国内,只考虑在国内部署CDN,用国外地址请求则会访问真实的服务器。5.网站的邮箱服务器
邮箱服务器大部分不会做CDN,所以是真实IP的几率很高。6.一些工具网站
查找真实IP:
https://get-site-ip.com/
工具:
https://github.com/boy-hack/w8fuckcdn
https://github.com/Tai7sy/fuckcdn四、端口扫描
1、端口扫描技术
通常使用专门的端口扫描工具来进行。可以详细收集目标开放的端口、服务、应用版本、操作系统、活跃主机等多种信息。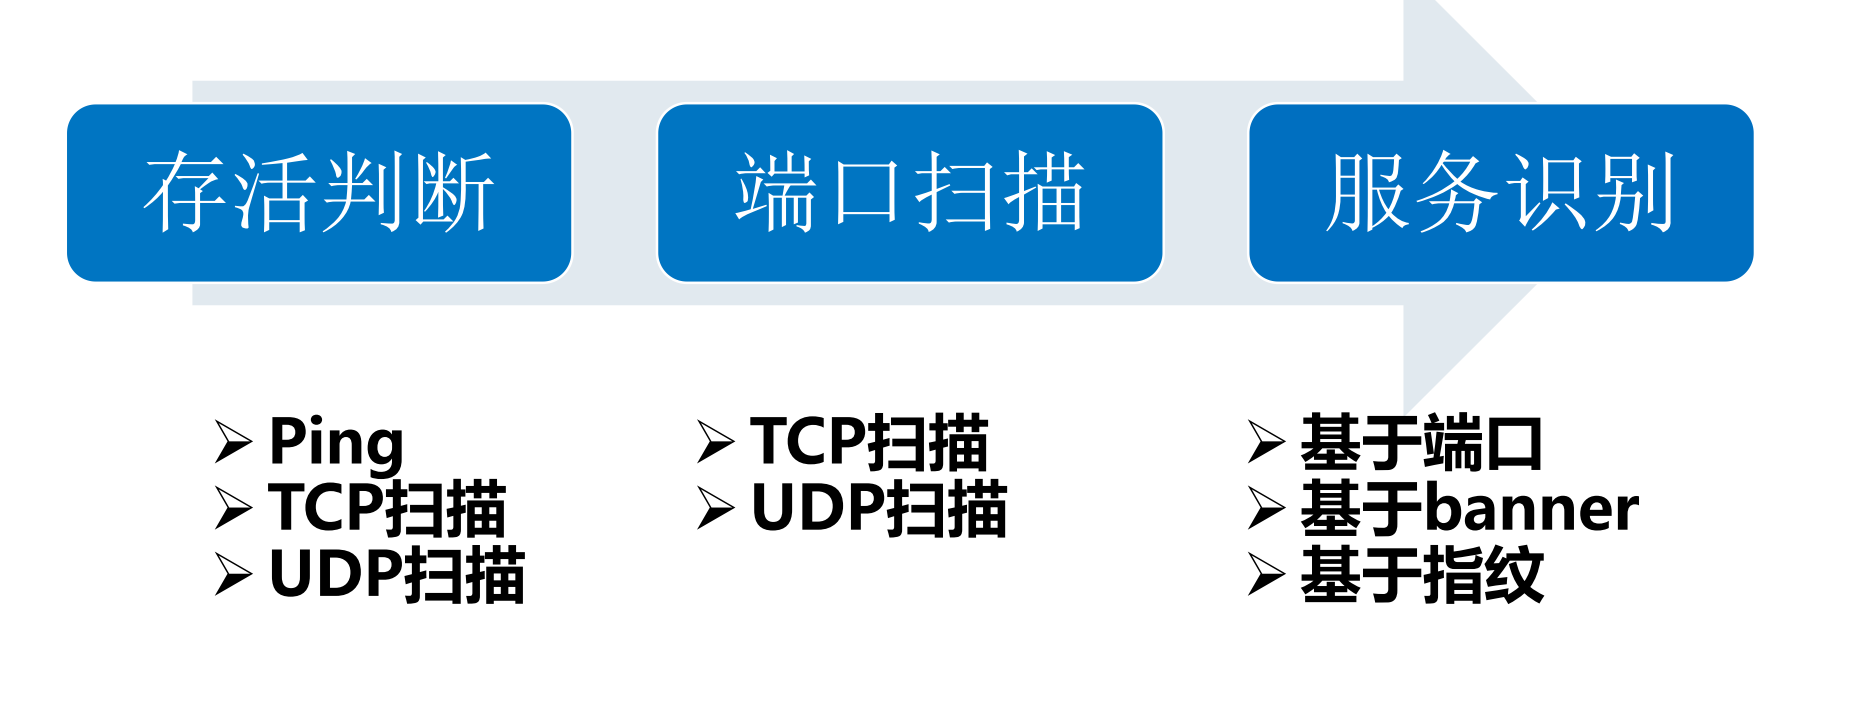
1)Nmap(NetworkMapper)
Nmap(NetworkMapper),在网络中具有强大的信息收集能力。
Nmap具备主机探测、服务/版本检测、操作系统检测、网络路由跟踪、Nmap脚本引擎的功能,在Kali中右键鼠标选择“打开终端”输入nmap和对应参数进行使用。
基本命令格式:nmap[参数]IP/IP段/主机名
如: nmap –v -sS –O 10.2.2.2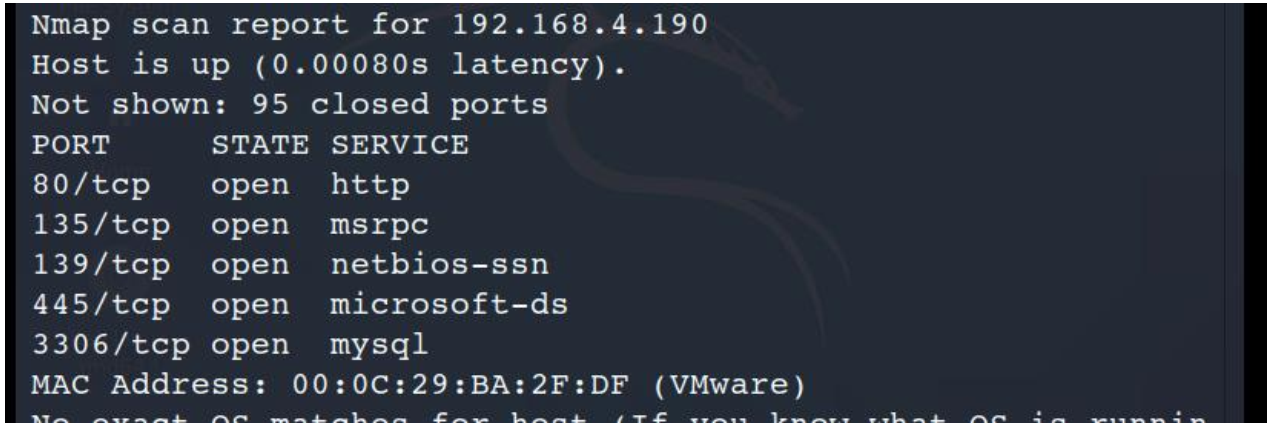
1.nmap -sT 192.168.96.4 //TCP连接扫描,不安全,慢
2.nmap -sS 192.168.96.4 //SYN扫描,使用最频繁,安全,快
3.nmap -Pn 192.168.96.4 //目标机禁用ping,绕过ping扫描
4.nmap -sU 192.168.96.4 //UDP扫描,慢,可得到有价值的服务器程序
5.nmap -sI 僵尸ip目标ip //使用僵尸机对目标机发送数据包
6.nmap -sA 192.168.96.4 //检测哪些端口被屏蔽
7.nmap 192.168.96.4 -p <portnumber> //对指定端口扫描
8.nmap 192.168.96.1/24 //对整个网段的主机进行扫描
9.nmap 192.168.96.4 -oX myscan.xml //对扫描结果另存在myscan.xml
10.nmap -T1~6 192.168.96.4 //设置扫描速度,一般T4足够。
11.nmap -sV 192.168.96.4 //对端口上的服务程序版本进行扫描
12.nmap -O 192.168.96.4 //对目标主机的操作系统进行扫描
13.nmap -sC <scirptfile> 192.168.96.4 //使用脚本进行扫描,耗时长
14.nmap -A 192.168.96.4 //强力扫描,耗时长
15.nmap -6 ipv6地址 //对ipv6地址的主机进行扫描
16.nmap -f 192.168.96.4 //使用小数据包发送,避免被识别出
17.nmap –mtu <size> 192.168.96.4 //发送的包大小,最大传输单元必须是8的整数
18.nmap -D <假ip> 192.168.96.4 //发送参杂着假ip的数据包检测
19.nmap --source-port <portnumber> //针对防火墙只允许的源端口
20.nmap –data-length: <length> 192.168.96.4 //改变发生数据包的默认的长度,避免被识别出来是nmap发送的。
21.nmap -v 192.168.96.4 //显示冗余信息(扫描细节)
22.nmap -sn 192.168.96.4 //对目标进行ping检测,不进行端口扫描(会发送四种报文确定目标是否存活,)
23.nmap -sP 192.168.96.4 //仅仅对目标进行ping检测。
24.nmap -n/-p 192.168.96.4 //-n表示不进行dns解析,-p表示要
25.nmap --system-dns 192.168.96.4 //扫描指定系统的dns服务器
26.nmap –traceroute 192.168.96.4 //追踪每个路由节点。
27.nmap -PE/PP/PM:使用ICMPecho,timestamp,andnetmask请求包发现主机。
28.nmap -sP 192.168.96.4 //主机存活性扫描,arp直连方式。
29.nmap -iR [number] //对随机生成number个地址进行扫描。五、黑暗搜索引擎
1、Shodan
CNNMoney的一篇文章写道,虽然目前人们都认为谷歌是最强劲的搜索引擎,但Shodan才是互联网上最可怕的搜索引擎。
与谷歌不同的是,Shodan不是在网上搜索网址,而是直接进入互联网的背后通道。Shodan可以说是一款“黑暗”谷歌,一刻不停的在寻找着所有和互联网关联的服务器、摄像头、打印机、路由器等等。每个月Shodan都会在大约5亿个服务器上日夜不停地搜集信息。2、ZoomEye
国内互联网安全厂商知道创宇开放了他们的海量数据库,对之前沉淀的数据进行了整合、整理,打造了一个名符其实的网络空间搜索引擎ZoomEye,该搜索引擎的后端数据计划包括两部分:
1,网站组件指纹:包括操作系统,Web服务,服务端语言,Web开发框架,Web应用,前端库及第三方组件等等。
2,主机设备指纹:结合NMAP大规模扫描结果进行整合。
目前只上线了第一部分网站组件指纹。3、Fofa
Fofa是白帽汇推出的一款网络空间搜索引擎,它通过进行网络空间测绘,能够帮助研究人员或者企业迅速进行网络资产匹配。例如进行漏洞影响范围分析、应用分布统计、应用流行度等。在渗透测试过程中,Fofa能帮助测试人员快速发现目标资产。 闽公网安备 35050402880173号